過学習とは?AI開発の落とし穴と原因・見分け方・対策を徹底解説
AIや機械学習のプロジェクトにおいて、「開発環境では精度99%を叩き出したモデルが、実際の現場に投入された途端に的外れな予測を連発する」というトラブルは頻繁に発生しています。この現象を引き起こす最大の元凶が、機械学習の成否を分ける過学習(オーバーフィッティング)です。
モデルが訓練データの特徴を捉えるにとどまらず、偶発的なノイズや特異な数値まで過剰に暗記してしまうと、未知のデータに対応する能力である「汎化性能」が著しく失われます。本記事では、過学習が起きる根本的なメカニズム、未学習との決定的な違い、グラフによる見分け方から、正則化や交差検証といった業界標準の防止策までを体系的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:過学習(オーバーフィッティング)とは、訓練データに過剰適合して未知データへの汎化性能が失われる現象。
- 要点2:主な原因は「モデル構造の過度な複雑さ」と「データの不足・偏り」。未学習(アンダーフィッティング)とは対称的な関係にある。
- 要点3:学習曲線グラフでの早期発見に加え、正則化(L1/L2)、ドロップアウト、交差検証法、早期終了(アーリーストッピング)による予防が不可欠。
【基礎知識】過学習(オーバーフィッティング)とは何か?なぜ訓練データだけ高スコアになるのか
機械学習における過学習(オーバーフィッティング / Overfitting)とは、構築したAIモデルが学習用の「訓練データ」に過度に適応しすぎてしまい、本番環境で投入される「テストデータ(未知のデータ)」に対して正しい予測ができなくなる状態を指します。
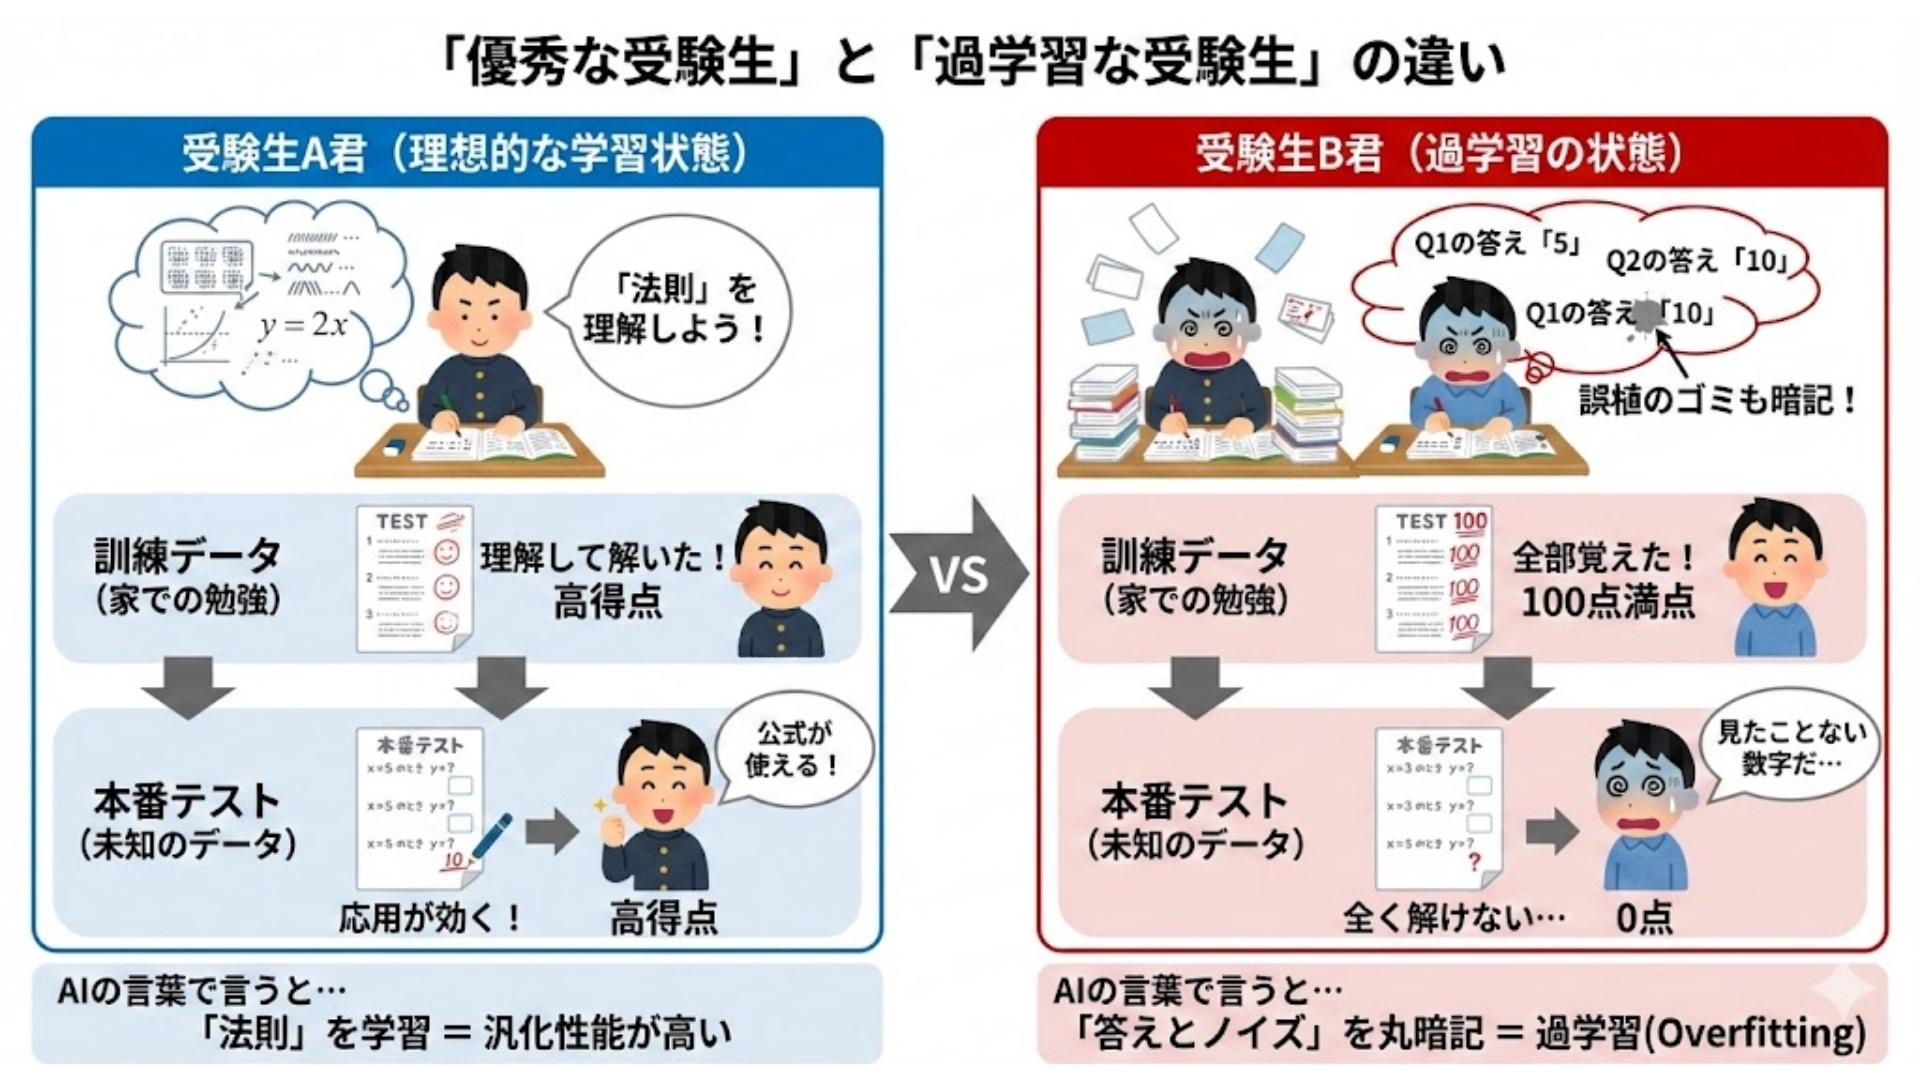
この現象を人間に例えるなら、「過去問題集の解答の数字や誤植まで一言一句丸暗記した受験生」と同じです。過去問と全く同じ問題が出題されれば満点を取れますが、数字や表現が少しでも変わった本番の試験問題には一切歯が立ちません。AIモデルも同様に、データ群の背後にある「本質的なパターンや法則性」を学ぶべきところを、個々のデータに含まれる「例外値やノイズ」まで完璧に再現しようとしてしまうことで発生します。
その結果、手元の訓練データでの評価スコアは100%に近い数値を記録する一方で、テストデータでの評価スコアが極端に低下するという致命的な精度の乖離(汎化ギャップ)が生じます。機械学習の本質的なゴールは、手元のデータを再現することではなく、未知のデータに対して正確な予測を下す汎化性能(Generalization Ability)の獲得にあります。過学習は、この汎化性能を破壊する最大の障壁です。
【メカニズム比較】過学習と未学習の違い|バイアスとバリアンスのトレードオフ
モデルの学習状態を正しく評価する上では、過学習と対をなす未学習(アンダーフィッティング / Underfitting)との違いを明確に把握しなければなりません。
未学習とは、モデルの表現力が低すぎる、あるいは学習が不十分であるために、訓練データの特徴すら捉えきれていない状態を指します。機械学習理論では、この関係性を「バイアス(偏り)」と「バリアンス(分散)」のトレードオフとして説明します。
- 高バイアス・低バリアンス(未学習):モデルが単純すぎて前提の仮定が強すぎる状態。訓練データもテストデータも共に精度が低い。
- 低バイアス・高バリアンス(過学習):モデルが複雑すぎて訓練データの細かな揺らぎに過敏に反応している状態。訓練データの誤差は極小だが、テストデータの誤差が大きい。
以下の比較表は、未学習・理想的な学習・過学習の3つの状態における特徴、指標の挙動、および典型的な対処アプローチをまとめたものです。
| 学習状態 | 詳細・数値データの挙動 | 一般的な基準・判定条件 | 技術的な改善アプローチ |
|---|---|---|---|
| 未学習 (Underfitting) | 訓練損失・検証損失ともに高い水準で高止まりする。 | 訓練データ正解率 < 70% テストデータ正解率 < 70% | モデルの層数・パラメータ追加、特徴量の追加、学習回数の増加。 |
| 理想的な学習 (Good Fit) | 訓練損失と検証損失がともに低水準で安定し、乖離が小さい。 | 訓練データ正解率 92%前後 テストデータ正解率 90%前後 | 現状のハイパーパラメータを維持し、本番環境へのデプロイ検証へ移行。 |
| 過学習 (Overfitting) | 訓練損失はゼロに近づくが、検証損失はある時点から急激に上昇する。 | 訓練データ正解率 99%以上 テストデータ正解率 60%台以下 | 正則化(L1/L2)、ドロップアウト、データ拡張、アーリーストッピング。 |
【原因の解剖】なぜAIは過学習に陥るのか?現場に潜む4大要因
過学習を引き起こすトリガーは単一ではありません。アルゴリズムの設計、データの品質、学習プロセスの制御など、複数の要素が絡み合って発生します。主要な原因は以下の4点に集約されます。
1. モデル構造の過度な複雑化(パラメータ過多)
線形回帰で十分な単純なデータ分布に対し、何十層ものディープニューラルネットワークを適用したり、高次の多項式モデルを採用したりすると、モデルの自由度(表現力)が高くなりすぎます。自由度が高すぎるモデルは、データ間の緩やかなトレンドではなく、個々のデータポイントの隙間を縫うような複雑怪奇な決定境界を引いてしまいます。
2. 訓練データのサンプル数不足と偏り(データスパースネス)
モデルの持つ表現力に対してデータ数が圧倒的に不足している場合、モデルは数少ないサンプルを無理やり一般化しようとします。例えば、10枚の画像だけで特定の物体を認識させようとすれば、背景の色や撮影角度といった偶発的要素を「物体の決定的な特徴」と誤認します。
3. 訓練データに含まれる外れ値・ノイズの過剰学習
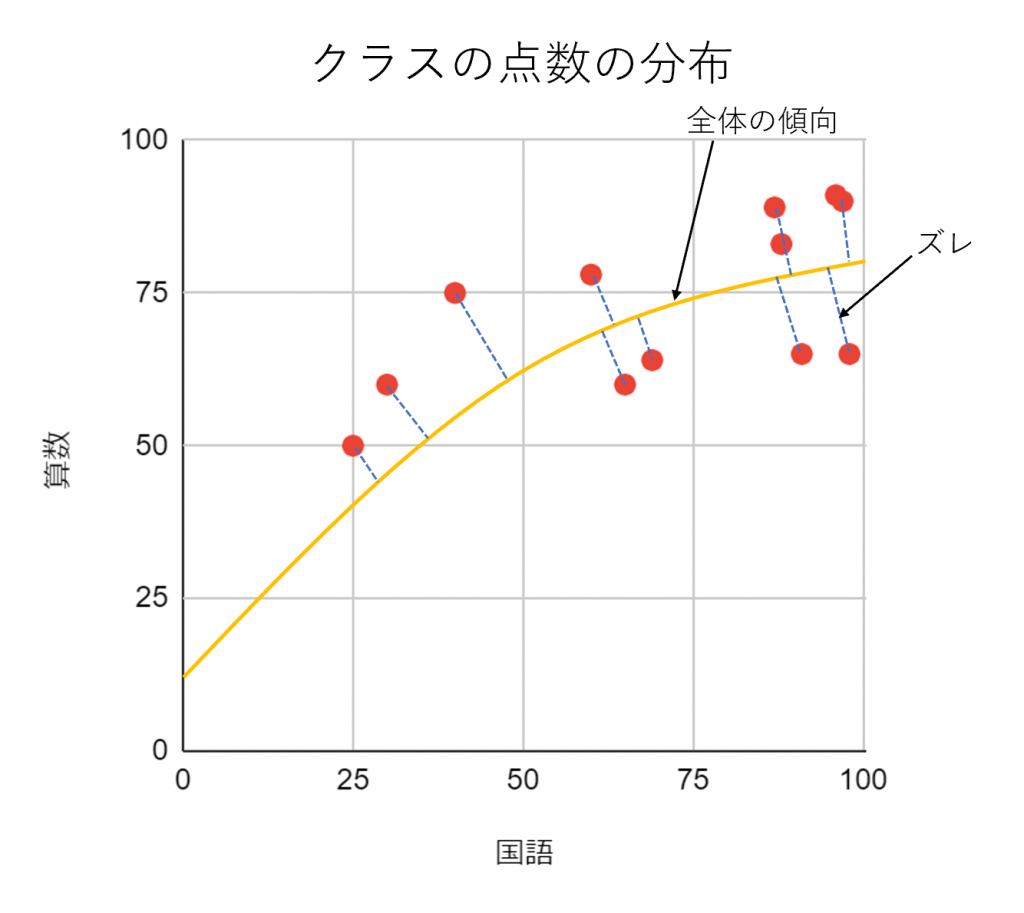
現実のデータセットには、センサーのエラー、入力ミス、極端な例外値などの「ノイズ」が必ず含まれます。頑健なモデルはノイズを無視して大局的な傾向を捉えますが、過学習に陥ったモデルはノイズにまで忠実にフィットしようとするため、本質的な法則性が歪められます。
4. 反復学習(エポック数)の過剰
ディープラーニングにおける過学習で最も頻発するのがこのパターンです。損失関数を最小化しようと同じデータセットで過度に学習を繰り返す(エポック数を重ねる)と、最初のうちは汎用的な特徴を学んでいたネットワークが、次第に訓練データの微小な誤差を埋めるだけの最適化へとシフトしていきます。
【見分け方】学習曲線グラフの見方と交差検証法(クロスバリデーション)
過学習の発生を検知するための最も確実な手法は、学習曲線グラフ(Learning Curve)の可視化と交差検証法(クロスバリデーション)の2つです。
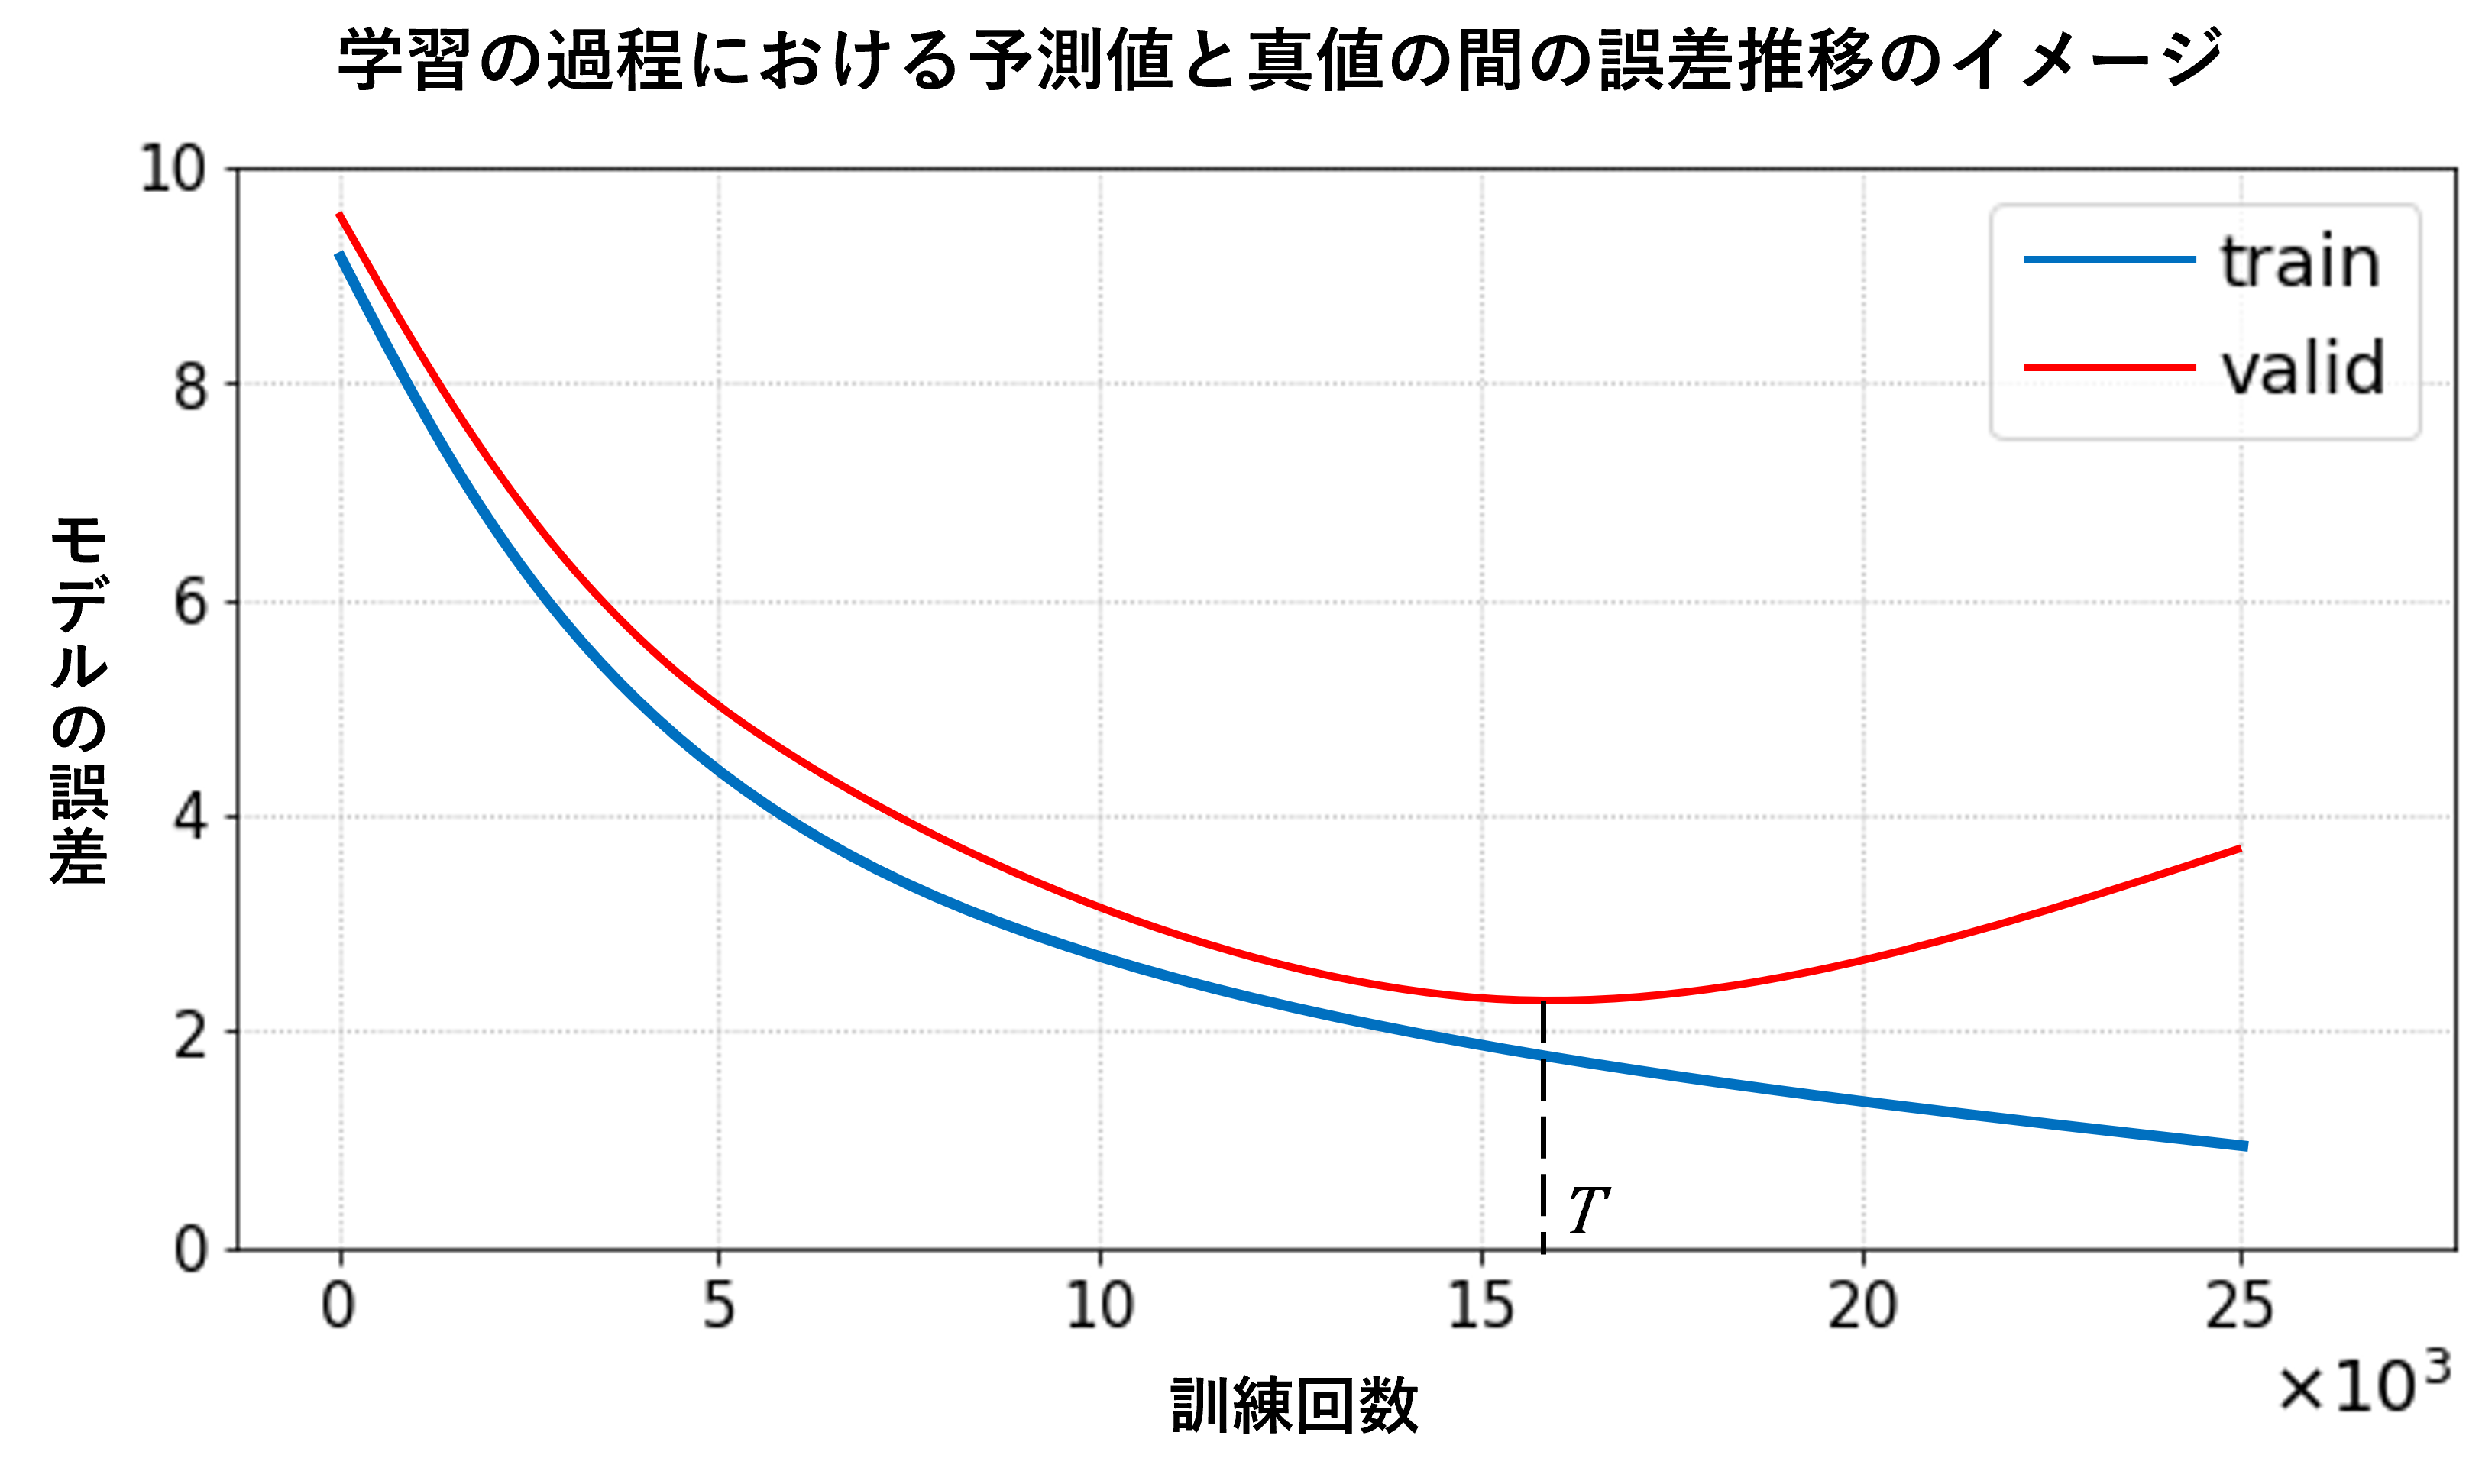
学習の進行(エポック数)に伴う損失値(Loss)の推移をプロットしたグラフは、過学習を診断する決定的なモニタリングツールとなります。
- 正常な学習曲線:エポック数が進むにつれて、「訓練データの損失(Train Loss)」と「検証データの損失(Validation Loss)」が揃って滑らかに下降し、低い値で平行線を保ちます。
- 過学習を示す学習曲線:Train Lossは単調減少し続けてほぼ0に近づくのに対し、Validation Lossはある地点を底にして再び上昇に転じる(U字カーブを描く)現象が確認されます。このTrainとValidationの乖離が開き始めたポイントこそが、過学習が始まった決定的な合図です。
また、データセットを効率的かつ厳密に評価するために標準的に用いられるのが交差検証法(K-分割交差検証 / K-Fold Cross Validation)です。手元の全データをK個(一般には5〜10個)のグループに均等分割し、そのうち1つをテスト用、残り「K-1個」を訓練用として学習と検証をK回繰り返します。
特定の分割パターンによる偶然の偏りを排除し、K回の検証スコアの平均値を算出することで、モデルの真の汎化性能を客観的に測定できます。
【実践対策】過学習を防ぐ5大アプローチ|正則化・ドロップアウト・早期終了
過学習のメカニズムと検知方法が判明すれば、エンジニアリングによる対策を施すことが可能です。現代の機械学習・深層学習において標準的に実装されている5つの防止策を解説します。
1. 正則化(L1正則化 / L2正則化)
損失関数に「モデルの重み(パラメータの大きさ)」に対するペナルティ項を追加することで、モデルが複雑化しすぎるのを数学的に防ぐ手法です。
- L1正則化(Lasso回帰):不要な特徴量の重みを完全にゼロにする性質があります。実質的な特徴量選択が行われるため、次元削減やスパースなモデル構築に適しています。
- L2正則化(Ridge回帰 / Weight Decay):重みが極端に大きな値を取らないよう全体的に小さく抑え込みます。滑らかな決定境界を作り、過学習を抑制する効果が極めて高いのが特徴です。
2. ドロップアウト(Dropout)
ディープラーニングにおいて絶大な効果を発揮する正則化技術です。ニューラルネットワークの学習時、順伝播および逆伝播の計算において、中間層のノード(ニューロン)を一定の確率(例:20%〜50%)でランダムに無効化(ドロップ)します。
特定のニューロン同士が過度に依存し合う「共適応」を防ぎ、アンサンブル学習(複数の異なるモデルの予測を統合する手法)と同様の強力な汎化効果を単一モデル内でもたらします。
3. 早期終了(アーリーストッピング / Early Stopping)
検証データに対する損失(Validation Loss)を監視し、損失が一定エポック数にわたって改善しなくなった(または悪化し始めた)瞬間に、学習を自動的に中断する手法です。モデルが訓練データの過剰適合を始める直前の「最も汎化性能が高い状態」のパラメータを自動的に保存・復元できます。
4. データ拡張(Data Augmentation)
訓練データそのものを人工的に増幅させる手法です。画像データであれば「回転・拡大縮小・左右反転・色相変更・ノイズ付加」、テキストデータであれば「同義語置換・逆翻訳」などを適用します。データの本質を変えずにバリエーションを爆発的に増やすことで、モデルが些細な変化に惑わされない頑健性を獲得します。
5. アンサンブル学習(バギング・ブースティング)
単一の巨大なモデルに頼るのではなく、ランダムフォレストや勾配ブースティング(LightGBM / XGBoost)のように、複数の弱学習器を組み合わせて最終的な予測を導き出します。個々のモデルのバリアンス(過学習傾向)を相殺し、安定した汎化性能を実現します。
【実態検証と現場の盲点】「精度99%の罠」にハマる開発現場のリアルと誤解
AI開発現場やコンペティションの現場では、過学習に関する誤った認識が原因でプロジェクトが頓挫するケースが散見されます。代表的な2つの盲点と誤解を解き明かします。
盲点1:データリーケージ(情報漏洩)による「偽りの高精度」
過学習と並んで開発者を欺くのが「データリーケージ」です。前処理(スケーリングや欠損値補完、特徴量エンジニアリング)をデータセット全体の分割前に行ってしまうと、テストデータに含まれる統計情報が訓練データに漏洩します。これにより、一見すると過学習を起こさずテストスコアが高いように見えても、本番環境の完全な未知データでは予測精度が崩壊します。
盲点2:「ビッグデータを用意すれば過学習は起きない」という神話
「データ量さえ増やせば過学習は解決する」という言説は半分正しく、半分は誤りです。現代のLLM(大規模言語モデル)や超巨大なニューラルネットワークは数千億個のパラメータを持ちます。どれほどデータが多くとも、モデルのパラメータ数がそれを上回る速度で増大すれば、過学習は構造的に発生します。データの「量」だけでなく、「ノイズの除去」「アノテーション精度の担保」といった「データの質」の管理が不可欠です。
【プロの結論】モデル選定における判断基準とエンジニアリングの本質
機械学習エンジニアリングにおける鉄則は、「オッカムの剃刀(同じ予測性能を持つならば、最も単純なモデルを選択すべき)」という哲学に帰着します。初期フェーズから複雑なディープラーニングを投入するのではなく、まずシンプルな線形モデルや決定木でベースラインを構築し、学習曲線を見ながら段階的にモデルの表現力を引き上げていくアプローチこそが、過学習を防ぐ最も堅実な防衛策です。
【過学習とは】に関するよくある質問(FAQ)
Q1:過学習が起きているかどうかは、どの指標を見れば一目で分かりますか?
A1:訓練データに対するスコア(正解率や損失)と、検証用(テスト)データに対するスコアの「差(汎化ギャップ)」を確認するのが最も確実です。訓練データの正解率が99%に達しているにもかかわらず、検証データの正解率が70%前後で停滞・下降している場合、明確に過学習が発生しています。
Q2:L1正則化とL2正則化はどのように使い分けるべきですか?
A2:特徴量の数が膨大で、明らかに不要な変数が多く含まれていることが想定される場合は、不要な重みをゼロにして特徴量を削ぎ落とす「L1正則化」が適しています。一方、大半の特徴量が予測に寄与しており、全体的な重みの暴走を滑らかに抑えたい場合は「L2正則化」を選択するのが一般的です。
Q3:生成AIや大規模言語モデル(LLM)でも過学習は起きるのですか?
A3:起きます。特に独自の業務データを用いてモデルを追加学習させる「ファインチューニング(LoRA等)」の工程において、データセットが小さすぎたり学習エポック数が多すぎたりすると、モデルが学習用の文章をそのまま丸暗記して出力する過学習(モード崩壊や表現の画一化)が発生します。
まとめ:汎化性能こそがAIの真価|過学習を制して実用的なモデルを構築する
機械学習モデルの価値は、手元のデータをどれだけ正確にトレースしたかではなく、「未知の現実世界でどれだけ正確な判断を下せるか」によって決まります。過学習は、AIが賢くなりすぎた結果ではなく、柔軟性を失って融通が利かなくなった状態です。
開発者は「精度の高さ」だけに惑わされることなく、交差検証法による厳密な性能測定、学習曲線の観察、正則化やアーリーストッピングといった予防策を設計段階から組み込む必要があります。過学習のメカニズムを正しく制御し、本番環境で真に機能する堅牢なAIモデルを構築していきましょう。 (出典: 過 学習 と は(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
