分散とは?データのばらつきを測る仕組みと二乗する理由を解説
データ分析やビジネスの意思決定、あるいは高校の数学や統計学の講義で必ず登場する「分散(ぶんさん)」。平均値は直感的に理解できても、分散の話になった途端に「数式が複雑でわかりにくい」「なぜわざわざ二乗して計算するのか納得できない」とつまずいてしまうケースは少なくありません。
テストの平均点が同じ50点だったとしても、「全員が45点〜55点に密集しているクラス」と「0点と100点に二極化しているクラス」では、集団の実態はまったく異なります。この「データの散らばり具合(ばらつき)」を正確に数値化するのが分散の役割です。この記事では、分散の根本的な意味から計算手順、標準偏差との違い、エクセルでの実践的な関数選定、さらには金融における分散投資への応用まで、統計の本質をわかりやすく紐解いていきます。
📌 【この記事の重要ポイントまとめ】
- 要点1:分散とは「各データが平均値からどれくらい離れているか(ばらつき)」を数値化した統計指標である。
- 要点2:計算過程で二乗する理由は、プラスとマイナスの偏差を打ち消さずに合計し、数学的に扱いやすく(微分可能に)するためである。
- 要点3:分散は単位が二乗されるため、実務やニュース報道では平方根をとった「標準偏差」に直して直感的なスケールで評価するのが一般的である。
【基本概念】分散とは何か?平均値だけでは見抜けない「データのばらつき」
統計学や確率論において、分散(英語:variance)とは「データの散らばりの度合い」を表す基本的な指標です。データ分析の現場では、まず平均値を算出することが多いですが、平均値だけではデータの全体像を正しく把握することはできません。
例えば、5人のグループAとグループBのテスト結果を比較してみましょう。
- グループAの点数:9点、10点、10点、10点、11点(平均:10点)
- グループBの点数:2点、5点、10点、15点、18点(平均:10点)
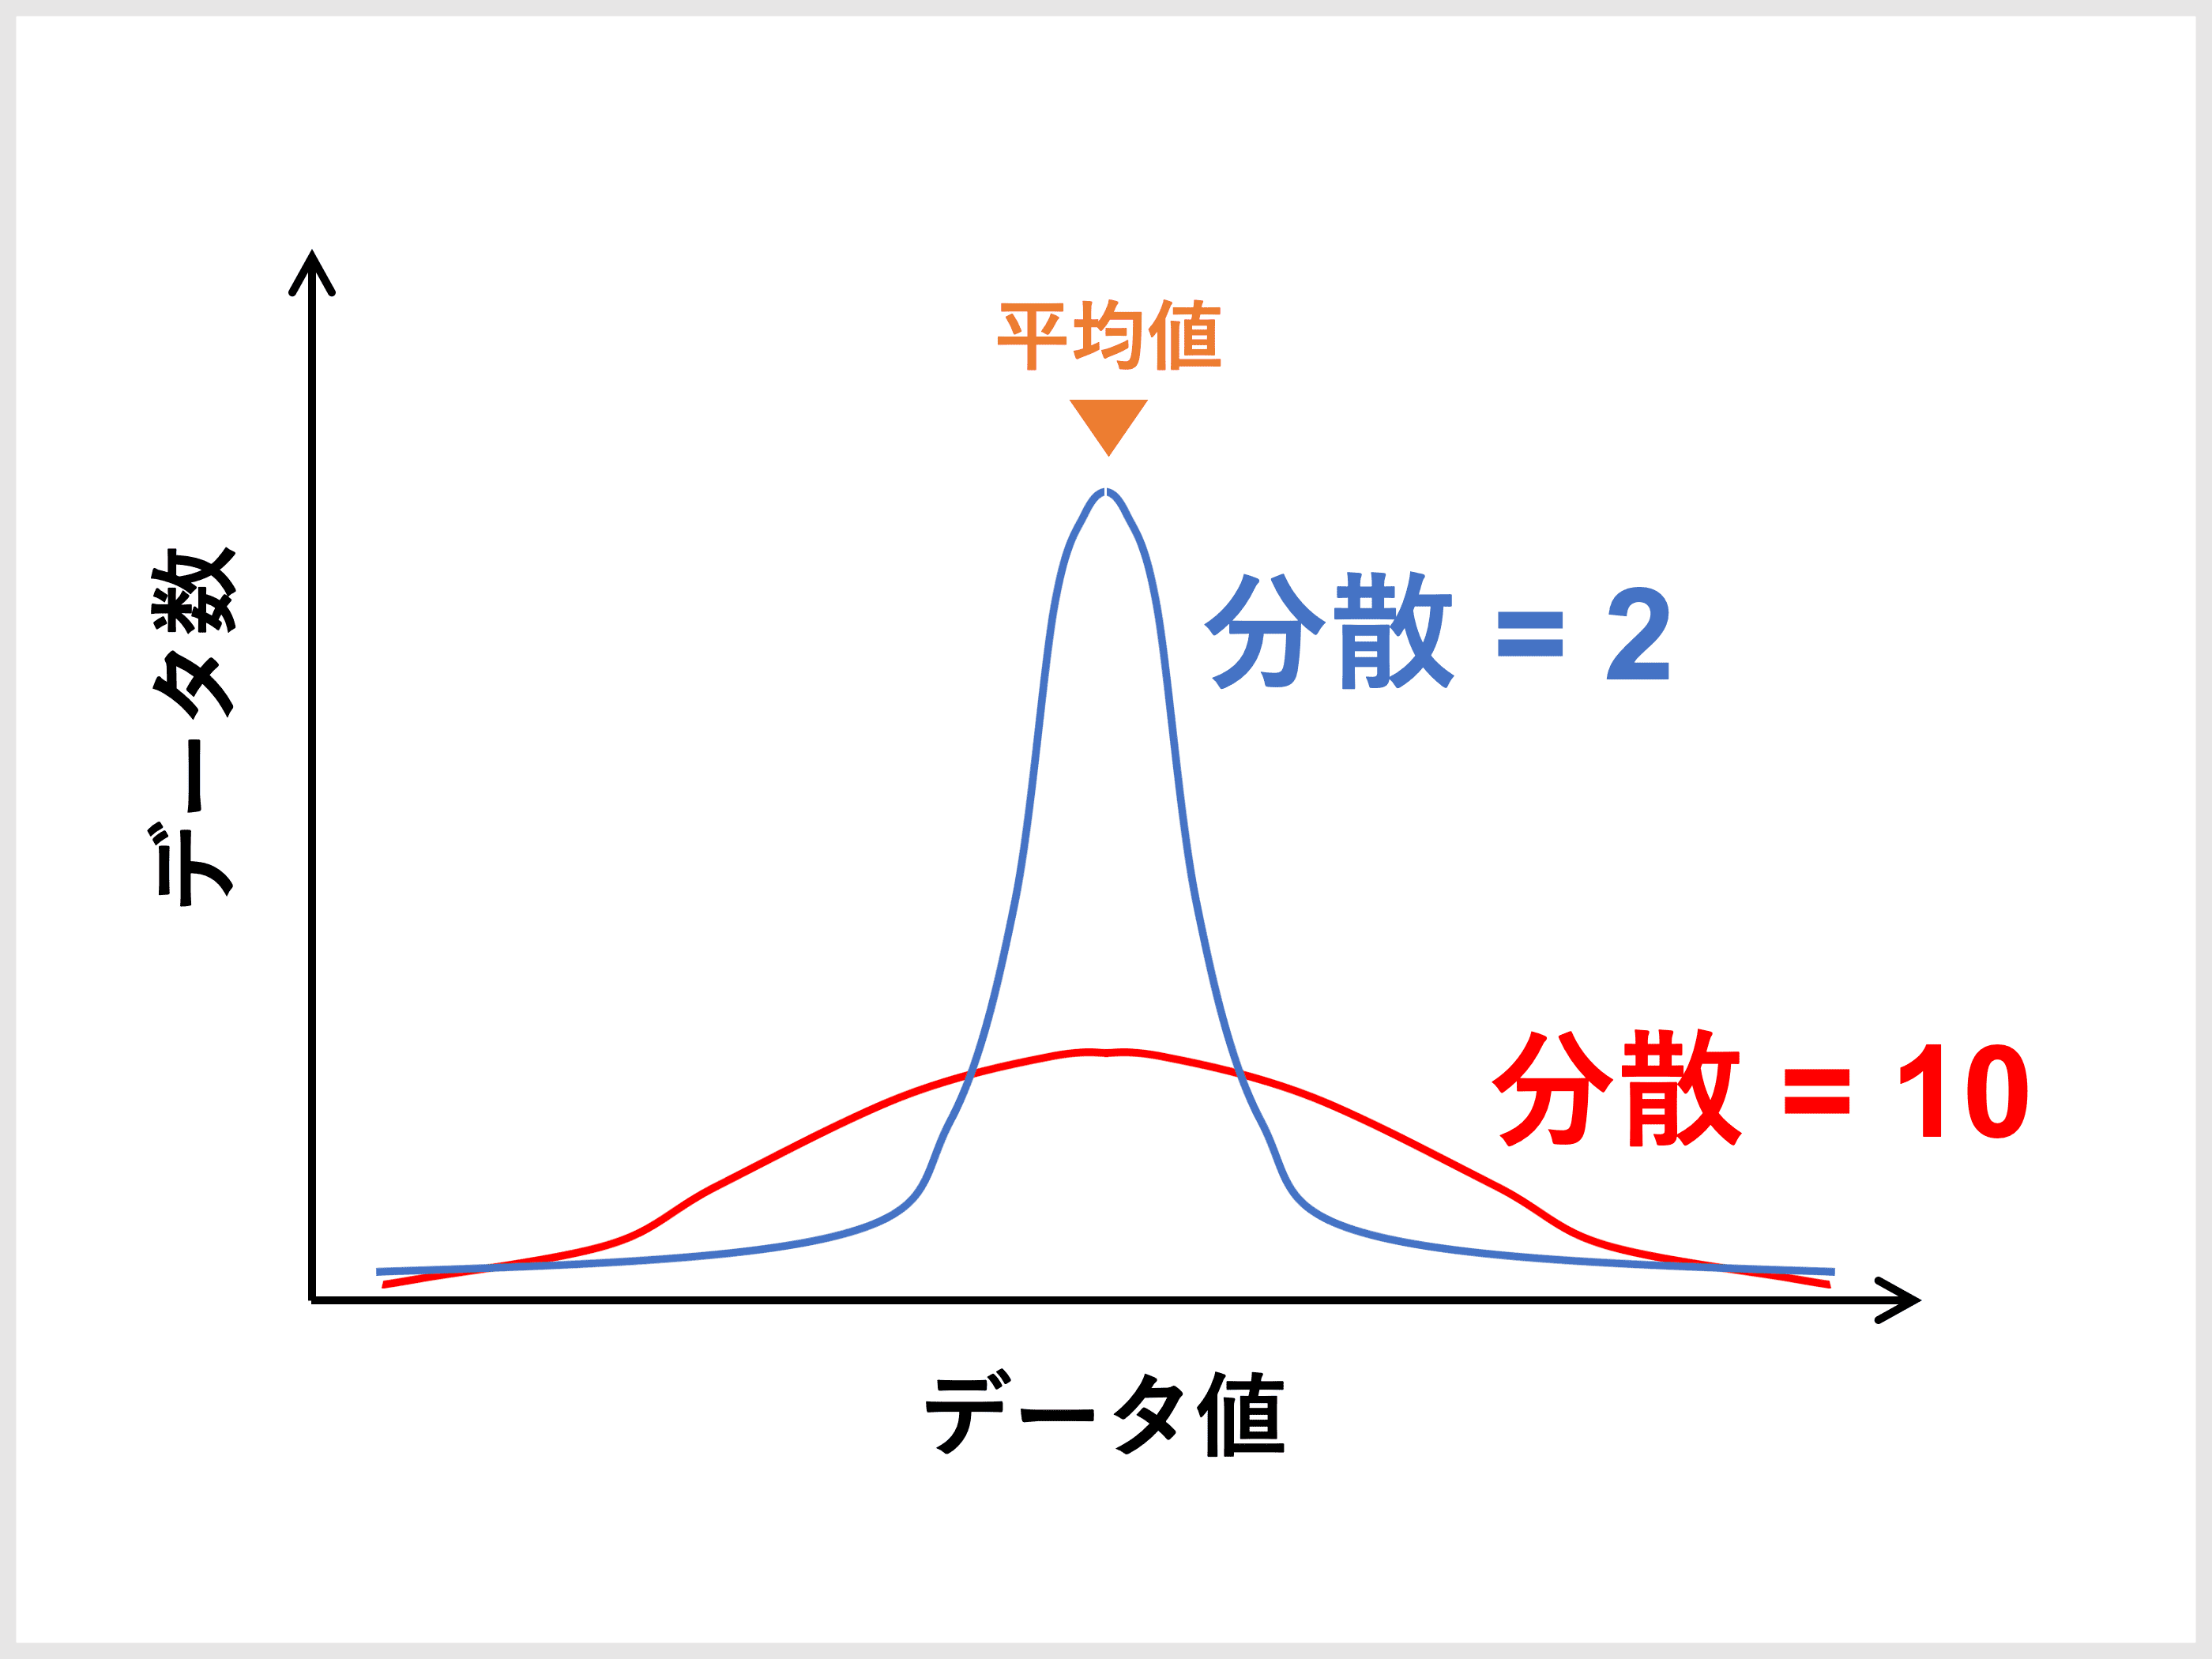
どちらのグループも平均値はまったく同じ10点です。しかし、データの分布を見れば一目瞭然なように、グループAは全員が平均値の近くに固まっているのに対し、グループBは点数の開きが非常に大きくなっています。この「散らばり具合の差」を客観的な数値として表したものが分散です。分散の値が小さいほどデータは平均値周辺に集中しており、値が大きいほどデータが広範囲に散らばっていることを示します。
分散を求めるための第一歩は、個々のデータと平均値の差である「偏差(へんさ)」を把握することです。偏差は「(個々のデータの値)−(データの平均値)」で求められます。
【最大の疑問を解明】なぜ二乗するのか?偏差の合計がゼロになる数学的罠
分散の計算式を見た多くの初学者が抱く疑問が、「なぜ偏差をわざわざ2乗しなければならないのか?」という点です。単純に「平均からのズレの大きさ」を知りたいのであれば、偏差の平均を取ればよいのではないかと直感的には思えます。
しかし、ここには「偏差の総和は必ずゼロになる」という数学的性質が存在します。先ほどのグループB(2, 5, 10, 15, 18 / 平均10)の偏差を計算してみましょう。
- 2 − 10 = −8
- 5 − 10 = −5
- 10 − 10 = 0
- 15 − 10 = +5
- 18 − 10 = +8
これらをそのまま足し合わせると、(−8)+(−5)+ 0 + 5 + 8 = 0 となり、どんなデータ群であっても平均からのズレの合計は完全に相殺されてゼロになってしまいます。これでは散らばり具合を数値化できません。
そこで、マイナスの符号を消してすべてのズレを正の値として評価するために「各偏差を2乗する」というアプローチが採られます。絶対値をつけて計算する手法(平均偏差)も存在しますが、二乗する方法には「関数として滑らかで微分計算がしやすい」「確率論の正規分布や最小二乗法と美しく整合する」「極端な外れ値をより強く検出できる」といった高度な数学的・統計的メリットがあるため、現代の統計学では分散がデファクトスタンダードとして定着しています。
【完全網羅】分散の求め方と計算式|高校数学から実務まで使える2つの公式
分散を計算する方法には、定義に基づいた「基本公式」と、計算の手間を大幅に減らす「計算公式(裏ワザ的解法)」の2通りが存在します。高校数学の「データの分析」や統計検定でも必須となる知識です。
1. 定義通りの求め方(偏差の二乗の平均)
分散の基本定義は「偏差の二乗の平均値」です。データの個数を $n$、各データを $x_1, x_2, \dots, x_n$、平均値を $\bar{x}$ とすると、分散 $s^2$ は以下の計算式で定義されます。
$$s^2 = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2 = \frac{(x_1 - \bar{x})^2 + (x_2 - \bar{x})^2 + \dots + (x_n - \bar{x})^2}{n}$$
先ほどのグループB(2, 5, 10, 15, 18)で実際に計算してみます。
- 各偏差の二乗を計算:$(-8)^2 = 64$、$(-5)^2 = 25$、$0^2 = 0$、$5^2 = 25$、$8^2 = 64$
- 二乗の合計を算出:$64 + 25 + 0 + 25 + 64 = 178$
- 個数(5)で割る:$178 \div 5 = \mathbf{35.6}$
これにより、グループBの分散は 35.6 と算出されます(ちなみにグループAの分散は 0.4 となり、散らばりの差が明確に浮き彫りになります)。
2. 実践的な計算公式(二乗の平均 − 平均の二乗)
平均値が小数や割り切れない値になった場合、定義通りに偏差を計算すると膨大な小数の引き算と二乗が必要になり、計算ミスが頻発します。そこで活用されるのが次の公式です。
「分散 = (各データの二乗の平均) − (平均値の二乗)」
$$s^2 = \overline{x^2} - (\bar{x})^2$$
この公式を使えば、元のデータを二乗した値の平均を出してから、あらかじめ求めておいた平均の二乗を引くだけで一気に分散が求まります。確率変数 $X$ と期待値 $E[X]$ を用いた確率論の分野でも、$V(X) = E[X^2] - (E[X])^2$ という同値の公式として広く利用されています。

【実態検証とデータ比較】分散と標準偏差の決定的な違い|単位のズレと使い分け
分散を語る上で欠かせないのが「標準偏差(Standard Deviation)」との違いです。分散と標準偏差はどちらもデータのばらつきを表す指標ですが、決定的な違いは「単位(スケール)」にあります。
分散は計算の過程で数値を二乗しているため、単位も二乗されてしまいます。例えば、テストの点数(点)なら「$\text{点}^2$」、身長(cm)なら「$\text{cm}^2$」、金額(円)なら「$\text{円}^2$」となってしまい、元のデータと直感的に比較することが困難です。そこで、分散の正の平方根(ルート)を取り、単位を元のデータに戻したものが標準偏差($\sigma$ または $s$)です。
| 指標名 | 計算式・定義 | 単位(ディメンション) | 実務での主な役割と評価 |
|---|---|---|---|
| 分散(Variance) | 偏差の二乗の平均値 ($s^2$ または $\sigma^2$) | 元の単位の二乗 (例:$\text{cm}^2$, $\text{円}^2$) | 数式処理が容易なため、統計モデルの構築、機械学習の損失関数、分散分析(ANOVA)など理論的計算で主役となる。 |
| 標準偏差(Std Dev) | 分散の正の平方根 ($s = \sqrt{s^2}$) | 元のデータと同一 (例:$\text{cm}$, $\text{円}$, 点) | 直感的にばらつきの幅を把握できるため、学力偏差値の算出、品質管理(3シグマ基準)、世論調査の誤差表示などで多用される。 |
| 平均偏差(Mean Absolute Dev) | 偏差の絶対値の平均値 | 元のデータと同一 (例:$\text{cm}$, $\text{円}$, 点) | 外れ値の影響を極端に受けたくない場合に参照されるが、絶対値記号を含むため微分が難しく、理論統計では使用頻度が低い。 |
グループBの例では、分散が 35.6 であるのに対し、標準偏差は $\sqrt{35.6} \approx \mathbf{5.97\text{点}}$ となります。「平均点10点に対して、だいたい±6点前後のばらつきがある」と表現できるため、標準偏差のほうが人間にとって直感的に理解しやすいというメリットがあります。
【盲点の解消】標本分散と不偏分散の違い|なぜ「n-1」で割るのか?
データ分析の実務やエクセル(Excel)の関数を扱う際、最も多くの人が混乱するのが「標本分散」と「不偏分散(ふへんぶんさん)」の使い分けです。
「n」で割るか「n-1」で割るかの決定的な境界線
学校教育の数学で習う分散は、手元にあるデータすべてを対象とするため、データの個数「$n$」で割ります。これを標本分散(または母分散)と呼びます。
一方、統計的推定(一部のサンプル調査から日本全国や製造ライン全体の母集団を推測すること)を行う場合、手元のサンプルから計算した標本分散は、真の母集団の分散よりも少し小さめ(過小)に見積もられてしまうという数学的な偏り(バイアス)が生じます。
このズレを補正し、母集団の真のばらつきを正確に推定するために、分母を $n$ ではなく $n-1$(自由度) で割ったものが不偏分散です。
エクセルでの分散の計算手順と関数の使い分け
エクセルで分散を計算する際は、データの性質に応じて関数を正しく選択する必要があります。
- VAR.P 関数(または VARP):手元にあるデータそのものが対象のすべてである場合(母集団全体)に使用。分母は $n$。社内全社員のデータ分析や高校数学の解法と一致。
- VAR.S 関数(または VAR):手元のデータを「全体から抽出したサンプル(標本)」とみなし、全体のばらつきを推測する場合に使用。分母は $n-1$。市場調査やアンケート分析、品質管理で標準的に使用。
実務の現場では、全数調査でない限り「VAR.S」を使用するのが統計学的な鉄則です。この使い分けを誤ると、誤差の評価が甘くなってしまうため注意が必要です。

【応用とプロの結論】ビジネス・AI・分散投資の基礎知識へ広がる実践知
分散の概念は、単なる教科書上の計算にとどまらず、最先端のビジネスや金融実務、AI開発の根幹を支えています。
典型的な実例が、金融工学や資産形成における「分散投資の基礎知識」です。投資の世界では、株価のばらつき(変動リスク)を分散や標準偏差(ボラティリティ)で数値化します。相関関係の低い複数の資産に分散して投資することで、ポートフォリオ全体の期待リターンを維持したまま、全体の分散(リスク)だけを劇的に引き下げることが理論的に証明されています(現代ポートフォリオ理論)。
また、機械学習やAIアルゴリズムにおいても、予測値と正解データのズレを最小化する評価指標(平均二乗誤差:MSE)として、分散の計算原理がそのまま組み込まれています。
【プロの結論】データのばらつきを正しく読み解くための判断基準
実務でデータを見る際、「平均値が高いから安心」「平均点が同じだから同等」と判断するのは極めて危険です。意思決定を行う際は、以下の判断基準を必ずチェックしてください。
- 分散が小さい場合:再現性が高く、予測が安定している状態。工場での製品均一性や、安定した業務パフォーマンスの評価に適している。
- 分散が大きい場合:二極化や外れ値(超ハイパフォーマーと停滞層など)が潜んでいる状態。中央値やパーセンタイル値を併用し、集団の構造を深掘りする必要がある。
【分散 と は】に関するよくある質問(FAQ)
Q1:分散の値がマイナス(負の数)になることはありますか?
A1:分散がマイナスになることは絶対にありません。分散は「各偏差を二乗した値(必ず0以上)」を足し合わせてデータの個数で割るため、最小値は「すべてのデータが完全に同一のときのゼロ」であり、常に0以上の正の実数になります。もし計算結果がマイナスになった場合は、計算式の展開や符号の処理でミスが発生しています。
Q2:エクセルで分散を計算するとき、VAR.PとVAR.Sのどちらを使うべきですか?
A2:データが「対象のすべて(全数データ)」であれば VAR.P を、データが「全体から抜き取った一部(サンプル)」であり母集団を推計したい場合は VAR.S を使用します。一般的な顧客アンケートや実験サンプル、抜き取り検査などでは基本的に VAR.S を選択するのが統計学的に適切です。
Q3:分散と標準偏差のどちらを使えばよいか迷ったときの基準は?
A3:人へのプレゼン資料、レポート、ニュース報道など「直感的なばらつきの幅」を伝えたいときは、単位が一致している 標準偏差 を使います。一方、数式モデルを組み立てたり、他の統計量と組み合わせて理論的な計算を進めたりする場合は、二乗根の処理が不要で扱いやすい 分散 を用います。
Q4:分散の「二乗」を外した「平均偏差」が一般に使われないのはなぜですか?
A4:絶対値を用いた平均偏差は、直感的で外れ値の影響を受けにくいメリットがあるものの、数学的に「絶対値記号を含む関数は尖った点(特異点)が生じて微分ができない」という致命的な扱いづらさがあります。正規分布や最小二乗法、回帰分析などの高度な理論体系とスムーズに連結させるため、微分可能な二乗を用いた分散が標準として使われています。
まとめ:データのばらつきを捉えて本質を見抜く視点
分散とは、データの平均値からのばらつきを数学的に厳密に数値化した基本指標です。「偏差の合計がゼロになるのを防ぐために二乗する」「単位を戻すために平方根を取ったものが標準偏差である」「全数調査か標本調査かによって $n$ と $n-1$ を使い分ける」という3つのポイントを押さえるだけで、統計の理解度は飛躍的に向上します。
平均値という一つの数字に惑わされず、分散を通じて背後にある「ばらつきの実態」を捉える視点を持つことは、データ主導のビジネスや学問において確実な判断を下すための強力な武器となります。 (出典: 分散 と は(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
