Seabornを使用した実践的コード(KDE: 密度推定曲線の同時描画)
ビジネスの意思決定や製造現場の工程管理において、「平均値」の数値だけを鵜呑みにして重大なトラブルを見落とす事例が後を絶ちません。売上の平均、製品寸法の平均、残業時間の平均――数値が想定の範囲内に収まっているからと安心していたら、実際は一部の極端な外れ値に引っ張られていただけだったという失敗は、データ活用の現場で日常茶飯事となっています。
そうした「数値の罠」を打ち破り、数値の散らばり具合を視覚的に浮き彫りにする必須ツールが「ヒストグラム」です。一見すると棒グラフと酷似しているため混同されがちですが、両者の本質はまったく異なります。本稿では、ヒストグラムの基礎概念から棒グラフとの決定的な相違点、度数分布表の読み解き方、エクセルやPythonを用いた実践的な作図法までをプロの視点から徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:ヒストグラムは連続するデータの散らばり(ばらつき)を可視化するグラフであり、カテゴリごとの数量を比較する棒グラフとは根本的な目的が異なる。
- 要点2:柱と柱の間に隙間を作らないのが統計上の原則であり、横軸の「階級幅」の設定次第でデータの見え方が激変するためスタージェスの公式などの客観的基準が不可欠である。
- 要点3:エクセルやPython(Seaborn/Matplotlib)を使えば数クリックや数行のコードで瞬時に生成可能であり、品質管理(QC)からマーケティングまで幅広く活用できる。
【基本定義】ヒストグラムとは?データのばらつきを可視化する統計学の基礎
ヒストグラムとは、連続した数値データをいくつかの区間(階級)に分割し、それぞれの区間に含まれるデータの個数(度数)を柱状の面積で表現したグラフです。統計学の基礎において、データ全体の分布形状を一目で把握するために最も広く用いられる手法の一つとして確立されています。
日本の製造業を世界最高峰の品質へと押し上げた「QC7つ道具」の一角としても知られており、現場で発生する製品の寸法誤差、重量のブレ、加工時間の偏りといったデータのばらつきを定量的にあぶり出す武器として重宝されてきました。
ヒストグラムを作成する際、土台となるのが「度数分布表」です。集めたデータを「階級(データを区切る区間)」「階級幅(区間の広さ)」「度数(その区間に入ったデータの数)」「累積度数(度数を順次足し合わせた数値)」に整理した一覧表を作成し、それをグラフィックへと落とし込むことで、数値の塊に隠された「形」が浮かび上がります。
棒グラフとの決定的な違い|見た目に騙されないための比較検証
「ヒストグラムと棒グラフは何が違うのか?」という疑問は、社内研修や統計の初学者から最も多く寄せられる質問の一つです。外見こそ同じ長方形の柱が並ぶスタイルですが、取り扱うデータの性質やグラフの構造には決定的な違いが存在します。
最大の相違点は、横軸の性質です。棒グラフの横軸は「商品カテゴリ(文房具、家電、食品)」「支店名(東京、大阪、名古屋)」といった互いに連続していない離散データ(質的データ)を並べます。そのため、棒の並び順を売上順や五十音順に自由に入れ替えてもグラフの意味は変わりません。
対するヒストグラムの横軸は、「身長」「テストの点数」「稼働時間」といった数値が途切れなく続く連続データ(量的データ)です。数値を昇順に並べた区間であるため、順番を勝手に入れ替えることは絶対に許されません。また、棒グラフは柱の「高さ」だけで数値を表現しますが、ヒストグラムは柱の幅(階級幅)×高さ(度数)で構成される「面積」そのものがデータの総量を意味しています。このため、正式なヒストグラムでは柱と柱の間に隙間を空けずに密着させて描画するのが世界共通のルールです。
| 項目 | 詳細・数値データ(ヒストグラム) | 一般的な基準・相場(棒グラフ) | 編集部の見解・評価 |
|---|---|---|---|
| 扱うデータの種類 | 量的データ(身長、重量、金額などの連続量) | 質的データ(部署名、地域、商品分類などの項目) | 混同の最大の原因。変数の測定尺度の見極めが必須。 |
| 横軸の並び替え | 並び替え不可(数値の大小順序が固定) | 自由に並び替え可能(降順、地域順など) | ヒストグラムの順序変更はデータの破壊を意味する。 |
| 柱同士の隙間 | 隙間なし(間隔0%で密着させる) | 隙間あり(視認性のため適度な間隔を設ける) | 隙間があるヒストグラムはエクセル等の初期設定不備。 |
| グラフが示す意味 | 面積がデータの度数(分布のばらつき・偏り)を表す | 柱の高さが各項目の絶対値を表す | 「散らばり」を見るか「大きさの比較」をするかの違い。 |
【実態検証】「平均値の罠」に泣く現場のリアルとSNS・コミュニティの声
大手製造業の品質管理部門に20年以上携わるベテラン技術者は、取材に対して次のような苦い経験を打ち明けました。
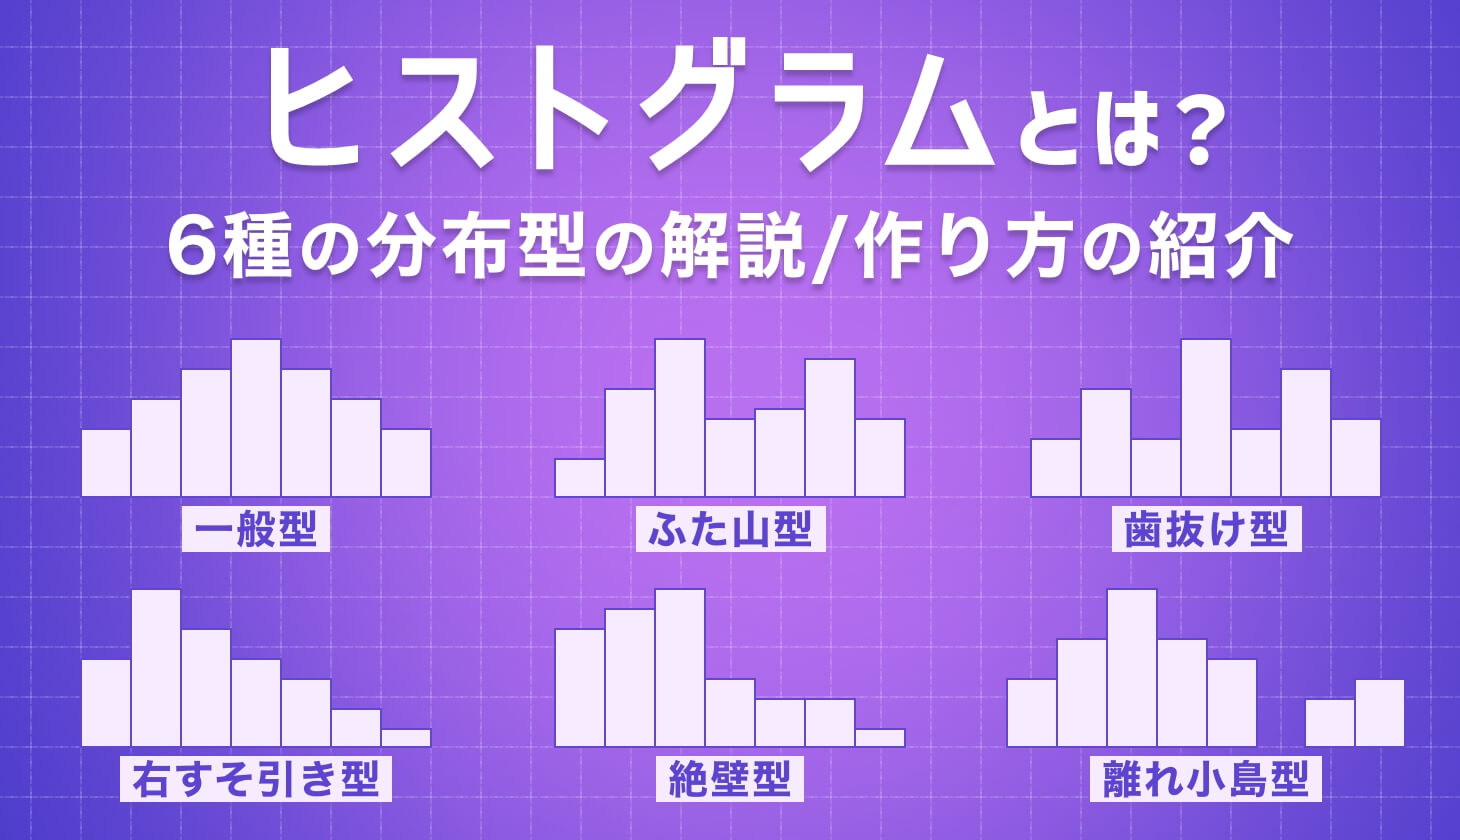
「新設した生産ラインで部品の厚みを測定したところ、平均値は図面通りの『10.0mm』ぴったりでした。幹部は合格を出しましたが、納品先から『組み立て時にガタつきが出る』と大クレームになったのです。慌てて測定データをヒストグラム化してみると、中央がくぼんだ『ふた山型(二峰型)』になっていました。9.0mmの不良ロットと11.0mmの不良ロットが半々で混ざり、見かけ上の平均値だけが10.0mmになっていたのです。平均値しか見ていなかった現場の完全な怠慢でした」
この告白が物語るように、平均値は直感的でわかりやすい指標である反面、データのばらつきを完全に隠蔽してしまいます。Yahoo!知恵袋やX(旧Twitter)上でも、「自社の平均年収が600万円と聞いて入社したが、一部の役員が数千万円稼いでいるだけで、一般社員の中央値は380万円だった」「平均顧客単価を基準に仕入れを計画したら、極端な高額購入者にデータが歪められていて大量の売れ残りを抱えた」といった悲鳴に満ちた投稿が目立ちます。
数値の分布が左右対称でない歪んだデータにおいては、平均値と中央値の間に巨大な乖離が生じます。現場の生の声を検証すればするほど、単一の要約統計量に頼る危険性と、ヒストグラムによって分布の生々しい実態を直接目で確かめることの重みが浮き彫りになります。
ヒストグラムの見方完全ガイド|形状パターンから読み解く異常のサイン
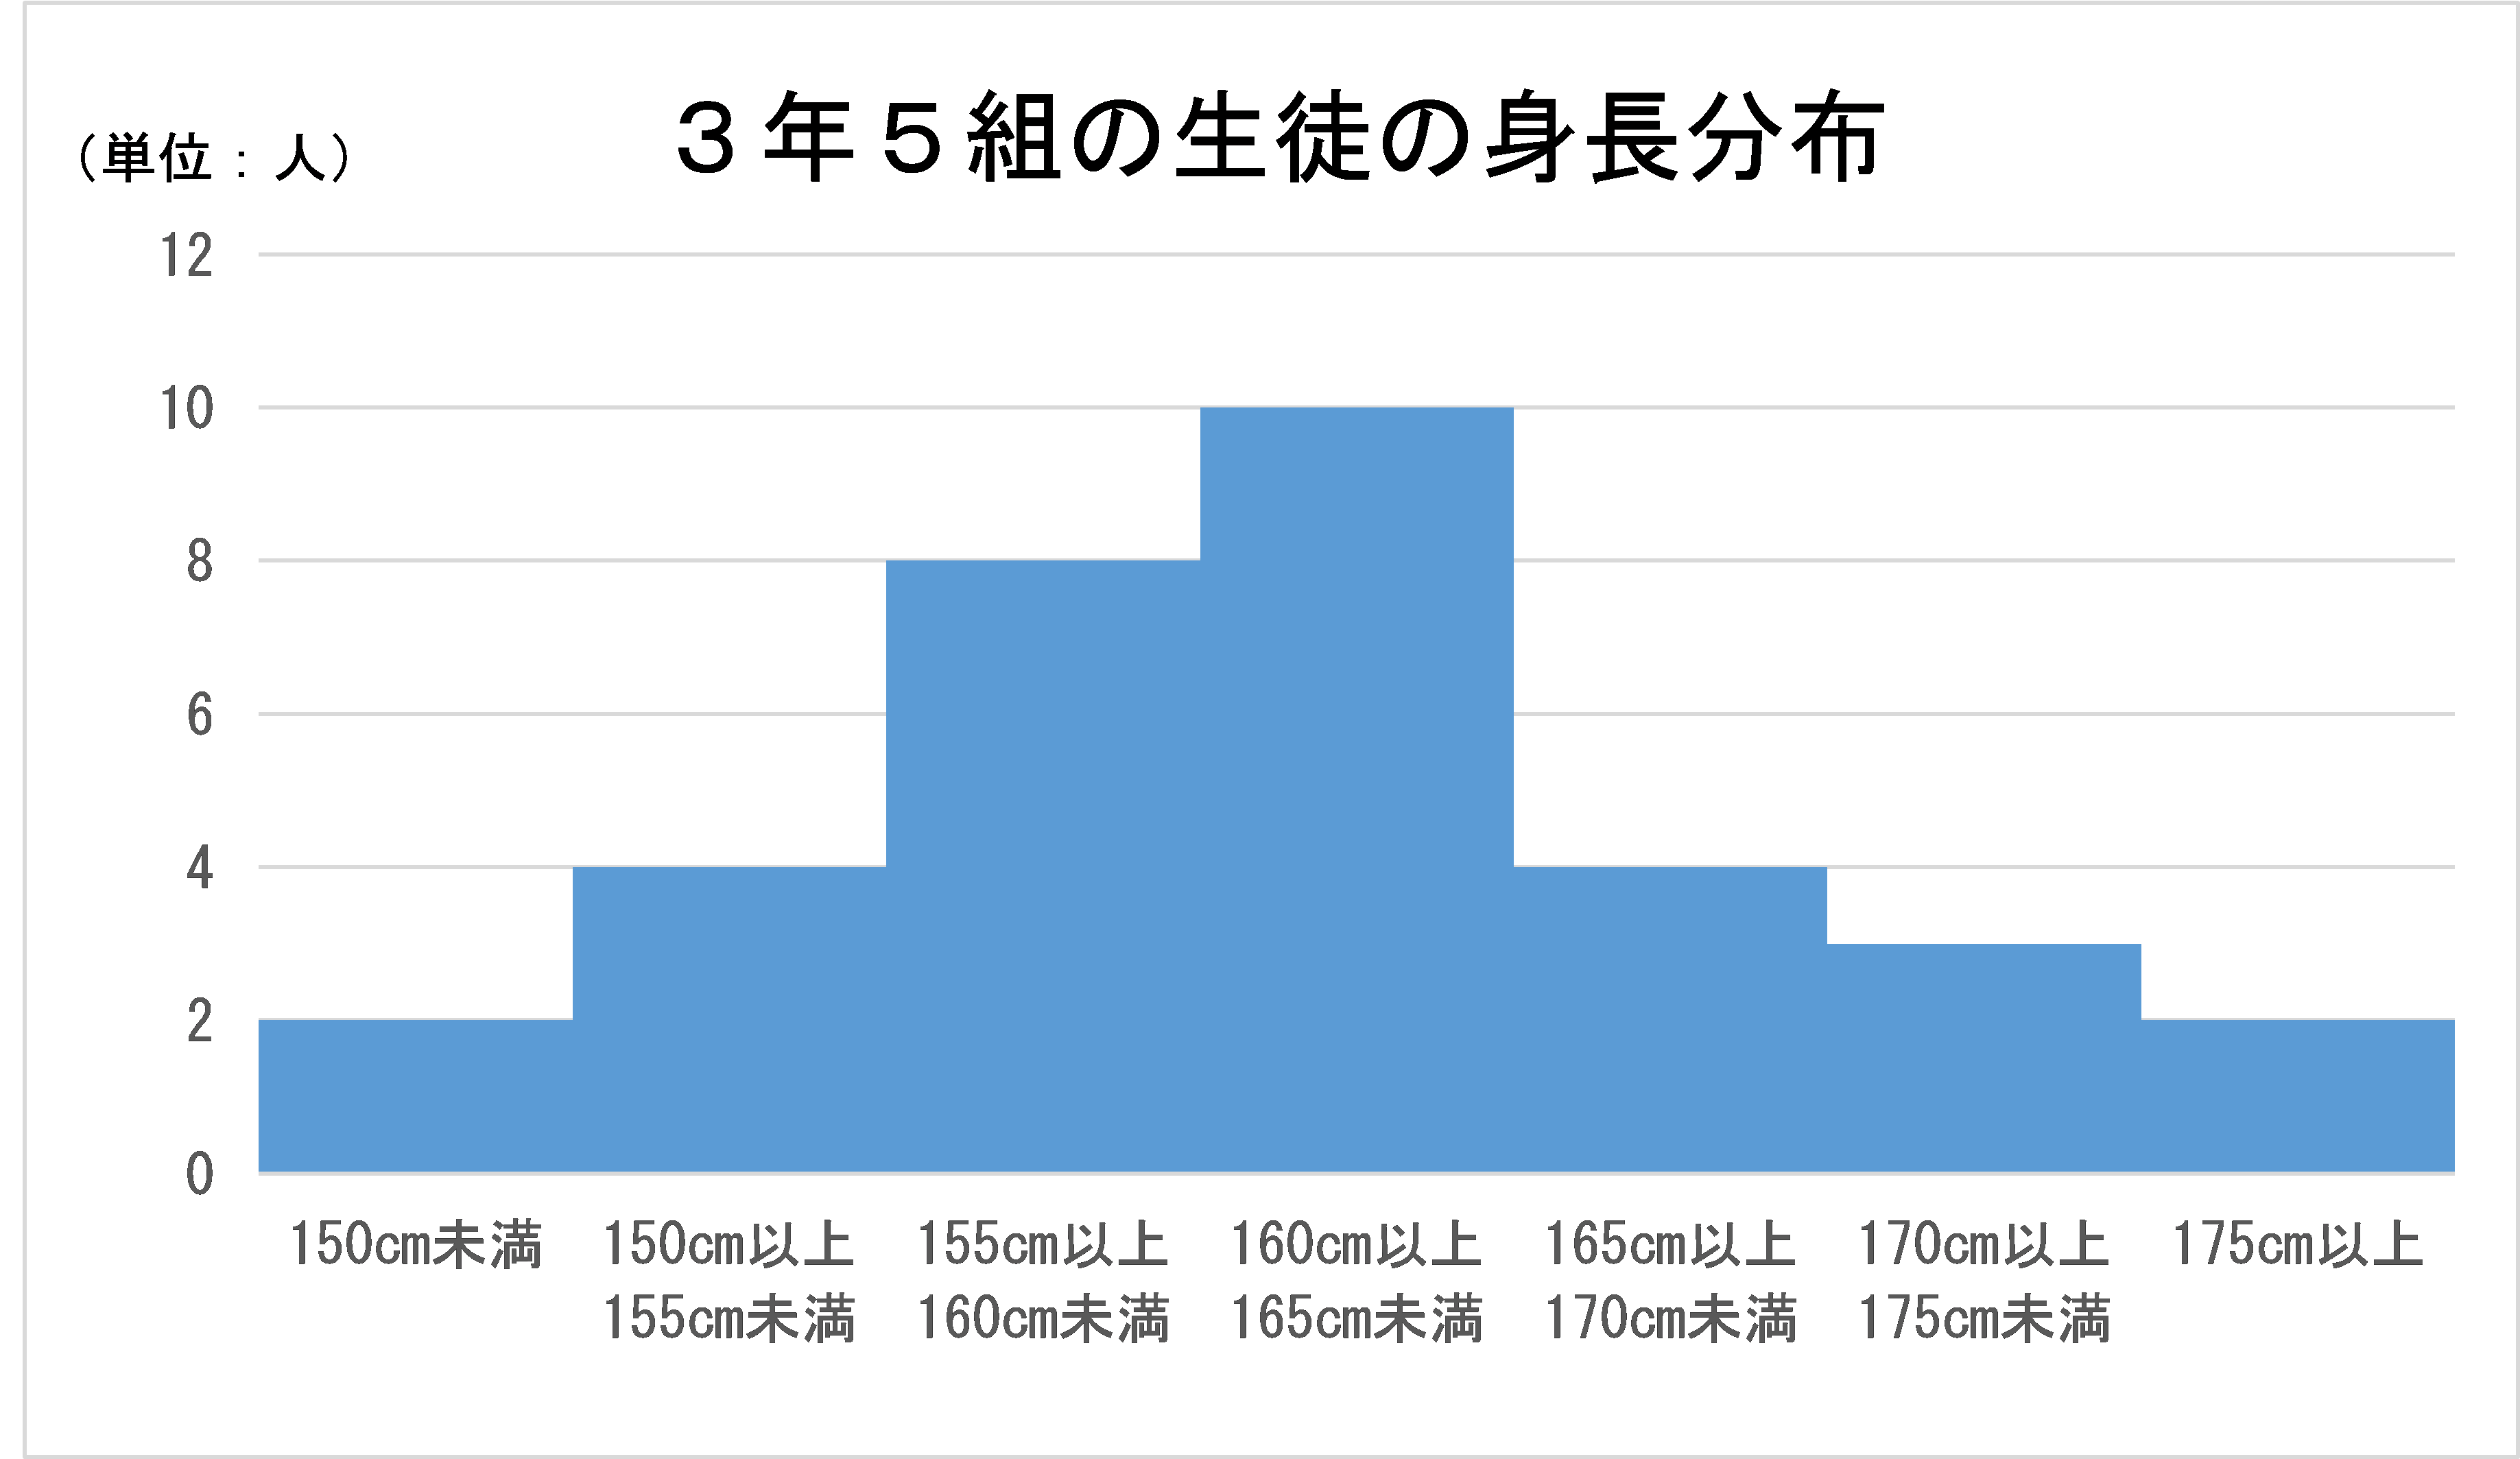
ヒストグラムをビジネスや研究に活かすためには、生成されたグラフの「形状」が何を意味しているのかを読み解くヒストグラムの見方を身につける必要があります。代表的な形状パターンは以下の4つに分類されます。
1. 左右対称のベル型(正規分布型)
中央の度数が最も高く、左右に向かって緩やかに度数が減少していく釣鐘状の形です。統計学の理想形である正規分布に近い状態を示しています。自然界の現象や、十分に管理された製造工程で部品を作った場合、この美しい山型が現れます。平均値と中央値、最頻値がほぼ一致しているため、平均値を代表値として信頼して差し支えありません。
2. 裾野が左右どちらかに伸びた歪み型(偏態型)
山が左(または右)に偏り、反対側へ長く尾を引いている形状です。所得分布やWebサイトの滞在時間、商品の購入頻度などで頻繁に観察されます。この場合、長い裾野にある極端な値に引っ張られるため、平均値は中央値から大きく乖離します。分析の基準には平均値ではなく中央値を用いるのが鉄則です。
3. 山が2つ存在する二峰型(ふた山型)
1つのグラフの中にピークが2箇所現れる形状です。これは、異なる性質を持つ2つの母集団が1つに混ざり合っている強力な証拠です。例えば、昼と夜の来店客データ、熟練工と新入社員の作業時間、異なる原材料ロットを区別せずに一括集計してしまった場合に発生します。直ちにデータを属性ごとに層別(グループ分け)して再分析する必要があります。
4. 孤立した柱が存在する外れ値型(離れ小島型)
大部分のデータから離れた場所に、ポツンと度数1〜2の低い柱が現れるパターンです。測定機器の誤作動、入力ミス、あるいは滅多に発生しない重大な異常が発生しているシグナルです。外れ値をそのまま放置して統計処理を行うと全体の結果が狂うため、原因究明が最優先課題となります。
一般に知られていない盲点とネットの誤解|階級幅の設定ミスが招く悲劇
インターネット上の解説記事では「エクセルで範囲を選んでボタンを押せば完成する」と安易に紹介されるケースが散見されます。しかし、データ分析の専門家が最も警鐘を鳴らすのが「階級幅の自動設定に起因する判断ミス」です。
ヒストグラムは、階級の幅を広く取りすぎると重要な情報が潰れて単なる四角いブロックのようになり、ばらつきが検知できなくなります。逆に階級幅を細かくしすぎると、柱がスカスカになり、偶然の誤差でグラフがギザギザになる「櫛の歯(くしのこ)現象」が発生して全体の傾向を見失います。
客観的に適切な階級数(柱の本数)を決める基準として、統計学では「スタージェスの公式」が広く活用されています。
スタージェスの公式:階級数 k ≒ 1 + log2(n)
(※ n は総データ数、log2 は底を2とする対数)
例えば、データ数が100件(n=100)の場合、1 + log2(100) ≒ 1 + 6.64 = 7.64 となり、階級数は「7本〜8本程度」にするのが最も自然な分布を捉えやすいと判断できます。データ数が1,000件であれば約11本です。ソフトウェアが勝手に決めた階級幅を鵜呑みにせず、データ量に応じた適切なスケールを設定できるかどうかが、プロと素人を分ける決定的な境界線となります。
【実践手順】度数分布表からの作り方とエクセル&Python活用術
実務でヒストグラムを自由自在に使いこなすための具体的な作成プロセスを解説します。手計算の基礎となる度数分布表の構築から、現代のビジネス実務で不可欠なソフトウェア操作までを網羅します。
ステップ1:度数分布表の設計
集めた生データから最大値と最小値を特定し、その差(全範囲)を求めます。スタージェスの公式などを参考に階級数を決定し、全範囲を階級数で割ることで1区間あたりの階級幅を算出します。各区間に該当するデータ数をカウントして度数を埋め、必要に応じて全体に対する割合(相対度数)や累積度数を算出して下準備を整えます。
ステップ2:ヒストグラムの作り方(エクセル編)
現代のMicrosoft Excel(2016以降・Microsoft 365環境)では、極めて直感的なヒストグラム 作り方 エクセルの手順が確立されています。
- 対象となる連続データ列をドラッグして選択する。
- 上部メニューの「挿入」タブから「統計グラフの挿入」アイコンをクリックし、「ヒストグラム」を選択する。
- 自動生成されたグラフの横軸をダブルクリックし、「軸の書式設定」を開く。
- 「ビンの幅」または「ビンの数」の項目を手動に切り替え、算出した階級幅(または階級数)を入力する。
- データ系列の書式設定から「要素の間隔」を「0%」に設定し、柱同士の隙間をなくす。
ステップ3:データサイエンス現場での作図(Python編)
数万件以上のログデータや機械学習の前処理においては、ヒストグラム Python環境での実装がスタンダードです。主に「Matplotlib」および「Seaborn」ライブラリを使用します。
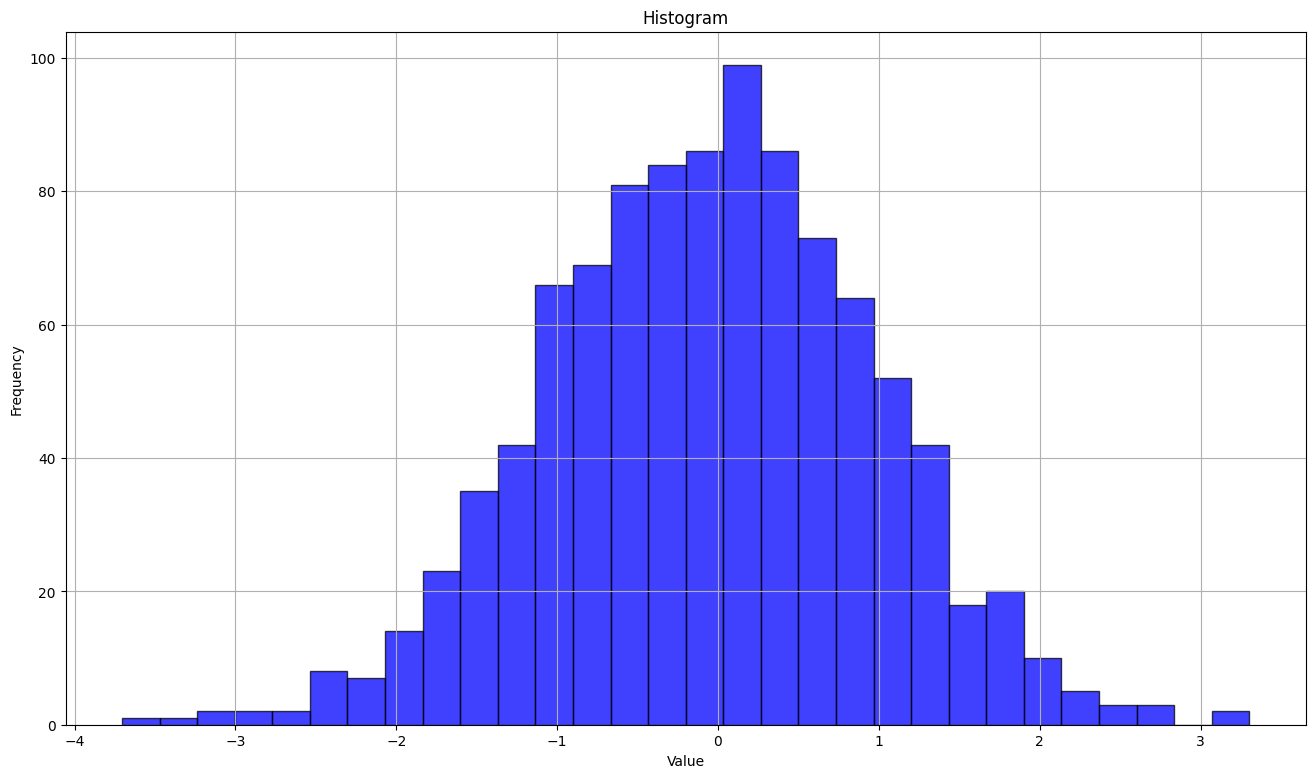
import matplotlib.pyplot as plt import seaborn as sns sns.set_theme(style="whitegrid") plt.figure(figsize=(8, 5)) sns.histplot(data=df['purchase_amount'], bins=15, kde=True, color='royalblue') plt.title('購入金額の度数分布(2026年実績値)', fontsize=14) plt.xlabel('購入金額 (円)', fontsize=12) plt.ylabel('顧客数 (度数)', fontsize=12) plt.tight_layout() plt.show() Pythonを用いる最大のメリットは、kde=Trueを指定することでヒストグラムの上に滑らかな確率密度関数(KDE曲線)を重ねて描画できる点です。これにより、階級幅の取り方による視覚的ノイズを補正し、データの真のトレンドを瞬時に見抜くことが可能になります。
【プロの結論】ヒストグラムを活用すべき人・慎重になるべき人の判断基準
データ分析の現場を統括してきた筆者の結論として、すべての場面でヒストグラムが万能なわけではありません。誤用を防ぐための明確な判断基準を提示します。
【今すぐヒストグラムを導入すべきケース】
- サンプルサイズが50件以上(推奨100件以上)ある連続データ:製造業の寸法検査、ECサイトの決済単価、社員の残業時間など、母集団の分布傾向を把握したい場合。
- 異常値や外れ値の有無をスクリーニングしたい場合:機械学習のデータクレンジングや品質管理の初期段階において必須。
- 平均値による報告に違和感を覚えている組織:一部の特異値に数字が歪められていないかを監査する強力な牽制機能となる。
【ヒストグラムの使用に慎重になるべきケース】
- サンプルサイズが30件未満の極小データ:データ数が少なすぎると、階級幅をどう変えても形状が激しく変動し、誤った意思決定を誘発するリスクがある(この場合はドットプロットや箱ひげ図、個別値プロットを優先すべき)。
- 時系列の変化(トレンド)を追いたい場合:ヒストグラムは時間の概念を捨て去って「集計」するグラフであるため、「先週から今週にかけてどう推移したか」を知りたい場合は管理図や折れ線グラフを用いるのが鉄則である。
【ヒストグラム と は】に関するよくある質問(FAQ)
Q1:度数分布表とヒストグラムはどちらを先に作るべきですか?
A1:論理的な手順としては「度数分布表」が先です。データを階級に分けて度数をカウントした集計表(度数分布表)があり、それをグラフィカルに可視化したものがヒストグラムだからです。ただし、最新のエクセルやPythonなどのツールを使用する場合は、生データを流し込むだけでツールが内部的に度数分布の計算を自動処理し、一気にヒストグラムを出力してくれます。
Q2:エクセルでヒストグラムを作ると柱同士に隙間が空いてしまいます。これは間違いですか?
A2:統計学的な厳密さの観点からは不適切です。隙間があると、離散データを表す「棒グラフ」と混同され、連続量の推移であることが伝わりにくくなります。エクセルのグラフ上でデータ系列を右クリックし、「データ系列の書式設定」から「要素の間隔」を「0%」に変更して隙間をなくすのが正式な表現作法です。
Q3:ヒストグラムの横軸にある数字が「[10, 20)」のような表記になっていますが、どういう意味ですか?
A3:これは区間の境界値の含み方を表す数学的な記号です。「[」や「]」は境界値を含み(以上・以下)、「(」や「)」は境界値を含まない(超・未満)を意味します。例えば「[10, 20)」と書かれている場合、「10以上20未満」のデータを集計した区間であることを示しています。
まとめ:データのばらつきを制する者が分析を制する
ヒストグラムは、単なるグラフ描画のテクニックにとどまらず、私たちが無意識に陥る「平均値という名の思考停止」から脱却するための極めて強力な思考フレームワークです。
棒グラフとの本質的な違いを理解し、適切な階級幅を選定してデータのばらつきを正しく可視化できれば、隠れていた工程の異常や顧客行動の二極化といった現場の「不都合な真実」が鮮明に浮かび上がってきます。まずは手元のエクセルデータから、平均値の裏に隠されたリアルな分布の形を確かめることから始めてみてください。 (出典: ヒストグラム と は(Yahoo!ニュース))
SEOライティングとマーケティング戦略の専門家。分かりやすい解説記事で定評があります。
