都市座標の生成(例: 15都市)
数百万通り、あるいは天文学的な組み合わせの中から「最も優れた答え」を導き出さなければならない時、従来の総当たり計算ではスーパーコンピュータを用いても何百年という時間を要してしまいます。この計算爆発の壁を打ち破るブレークスルーとして、半世紀にわたり進化計算の基盤を担ってきたのが遺伝的アルゴリズム(Genetic Algorithm: GA)です。
チャールズ・ダーウィンが提唱した「自然淘汰」と「適者生存」の進化論を計算科学へと昇華させたこの手法は、現代のAI技術や生成AIの進化と融合し、2026年のシステム設計や大規模最適化の現場でも中核的な役割を果たしています。なぜ生物の進化を模倣するだけで複雑な難問の最適解が見つかるのか、その深層メカニズムからPythonによる実践コード、機械学習との違いまで体系的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 核心概念:1975年にジョン・H・ホランドが提唱した、生物の「選択・交叉・突然変異」を模倣して準最適解を高速探索するメタヒューリスティクス手法。
- 適用領域:微分が使えない複雑な非線形問題や、巡回セールスマン問題(TSP)をはじめとする組み合わせ最適化問題で絶大な威力を発揮。
- 2026年の最新動向:ディープラーニングの構造探索(NAS)やLLMプロンプトの自動最適化、量子アニーリングとのハイブリッド技術として再脚光を浴びている。
【仕組みを解剖】生物の進化に学ぶ遺伝的アルゴリズムとは?なぜ最適解が見つかるのか
遺伝的アルゴリズム(GA)は、1975年にミシガン大学のジョン・H・ホランド(John Henry Holland)教授が著書『Adaptation in Natural and Artificial Systems』で体系化した計算手法です。数学的に厳密な数式解析が困難な「最適化問題」に対し、近似的な最適解(準最適解)を現実的な計算時間で導き出すメタヒューリスティクス手法の代表格として位置づけられています。
自然界において、環境に適応した個体ほど生存確率が高まり、その優れた遺伝子が後世に受け継がれていくように、遺伝的アルゴリズムでは「解の候補」を生物の個体に見立てて世代交代を繰り返します。東京大学名誉教授の伊庭斉彦氏らの研究資料にも示されている通り、GAのデータ構造は問題のパラメータを記号列として表現した遺伝子型(GTYPE: Genotype)と、それが実際の解として具現化された表現型(PTYPE: Phenotype)の二層構造で捉えるのが基本原理です。
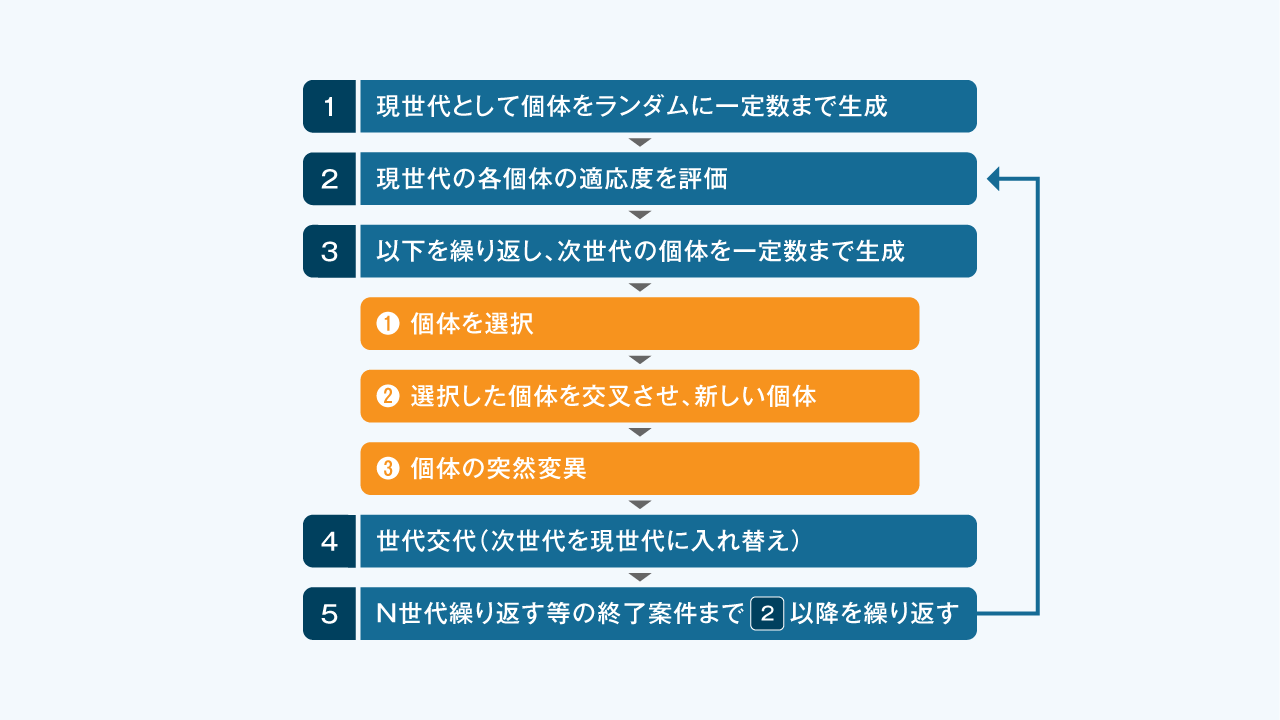
世代交代は、以下の厳密な3大操作のサイクルによって進行します。
- 選択(Selection):現在の個体群の中から、目的の性能を満たしている度合い(適応度: Fitness)が高い個体を優先的に選び出す操作。代表的な手法に、適応度に比例した確率で選ぶ「ルーレット選択」や、ランダムに選んだ少数個体の中で最優秀のものを残す「トーナメント選択」があります。
- 交叉(Crossover):選び出された親個体の遺伝子情報の一部を互いに組み替え、新しい子個体を生成する操作。「一点交叉」「二点交叉」「一様交叉」などがあり、親の長所を組み合わせたより優れた解の創出を狙います。
- 突然変異(Mutation):一定の低い確率で遺伝子の一部をランダムに変化させる操作。これによって集団内の遺伝的多様性を維持し、後述する局所解(ローカルミニマム)へのトラップを回避します。
さらに、前世代の最優秀個体をそのまま次世代へ無条件で引き継ぐエリート保存戦略(Elitism)を併用することで、探索の過程で偶然生まれた「過去最高の解」を取りこぼすリスクを完全に排除します。この「適者生存の淘汰圧」と「交叉・突然変異による探索空間の拡張」という二律背反のバランスこそが、未知の広大な探索空間から最適解を浮かび上がらせる決定的な理由です。

【徹底比較】機械学習・深層学習との決定的な違いとメリット・デメリット
現場のエンジニアや研究者から頻繁に寄せられる疑問が、「勾配降下法を用いる一般的な機械学習やディープラーニングと、遺伝的アルゴリズムは何が本質的に違うのか」という点です。
最大の違いは、解を探索する空間において「微分(勾配情報)を必要とするか否か」にあります。バックプロパゲーション(誤差逆伝播法)を基盤とする深層学習は、損失関数の傾きを計算してパラメータを更新するため、関数が滑らかで微分可能であることが前提です。一方、遺伝的アルゴリズムは評価関数の出力値(適応度)さえ得られれば、関数が不連続であっても、ルールベースのシミュレータであっても適用可能です。
| 比較項目 | 遺伝的アルゴリズム(GA) | 深層学習・勾配降下法 | 強化学習(RL) |
|---|---|---|---|
| 探索の前提条件 | 評価関数の出力のみ(微分不要) | 微分可能な損失関数が必須 | 環境からの報酬シグナルと状態遷移 |
| 得意な問題領域 | 組み合わせ最適化・離散空間・ブラックボックス | 画像・音声・テキストのパターン認識 | ロボット制御・ゲームプレイ等の動的意思決定 |
| 局所解への耐性 | 極めて高い(多点並列探索と突然変異) | 鞍点や局所解に捕まるリスクがある | 方策の早期収束リスクが存在する |
| 計算コスト・速度 | 評価回数が多く、適応度計算が重いと鈍化 | GPUによる並列テンソル計算で高速 | 試行錯誤の環境ステップ数に依存 |
遺伝的アルゴリズムのメリット
第一の強みは、多点同時探索によるグローバル最適解の発見力です。1つの解を逐次改善するアルゴリズムと異なり、数十〜数百の個体群が探索空間全体に網を張るため、局所的な罠を飛び越えて真の最適解に到達しやすくなります。また、各個体の適応度評価は完全に独立して行えるため、マルチコアCPUやクラスタ環境での分散並列処理と相性が極めて抜群です。
遺伝的アルゴリズムのデメリット
一方で、適応度関数の評価コストが最大のボトルネックになります。物理シミュレーションや重厚な計算を評価に含む場合、世代を重ねるごとに膨大な計算リソースを消費します。また、「絶対に理論的最適解に到達する」という厳密な数学的収束保証がないため、実務では一定世代数やスコアの停滞をもって探索を打ち切る割り切りが必要です。
【現場で動かす】Pythonによる遺伝的アルゴリズム実装と巡回セールスマン問題(TSP)
遺伝的アルゴリズムの真価を最も直感的に理解できるのが、NP困難問題の金字塔である巡回セールスマン問題(Traveling Salesperson Problem: TSP)です。都市の数が増えると総ルート数が階乗($N!$)で爆発し、例えばわずか20都市でも約$2.4 \times 10^{18}$通りの組み合わせが存在するため、総当たり計算は不可能です。
ここでは、Pythonを用いてシンプルなTSP用遺伝的アルゴリズムを構築する手順を解説します。都市の巡回順序を遺伝子として表現し、総移動距離の短さを適応度として定義します。
import numpy as np import random np.random.seed(42) num_cities = 15 cities = np.random.rand(num_cities, 2) * 100 def calculate_distance(route): """ルートの総移動距離を計算""" dist = 0 for i in range(len(route)): from_city = cities[route[i]] to_city = cities[route[(i + 1) % len(route)]] dist += np.linalg.norm(from_city - to_city) return dist def calculate_fitness(route): """適応度は距離の逆数(短いほど高評価)""" return 1.0 / calculate_distance(route) def ordered_crossover(parent1, parent2): """順序交叉(OX): 都市の重複を防ぎつつ順序を継承""" size = len(parent1) a, b = sorted(random.sample(range(size), 2)) child = [None] * size child[a:b] = parent1[a:b] ptr = b for gene in parent2[b:] + parent2[:b]: if gene not in child: if ptr >= size: ptr = 0 child[ptr] = gene ptr += 1 return child def mutate(route, mutation_rate=0.05): """突然変異: 2つの都市を入れ替える(スワップ変異)""" for i in range(len(route)): if random.random() < mutation_rate: j = random.randint(0, len(route) - 1) route[i], route[j] = route[j], route[i] return route # メイン実行ループ population_size = 100 generations = 300 population = [random.sample(range(num_cities), num_cities) for _ in range(population_size)] for gen in range(generations): # 適応度評価 fitness_scores = [calculate_fitness(ind) for ind in population] # 次世代集団の生成 new_population = [] # エリート保存(最優秀個体を1つ残す) best_idx = np.argmax(fitness_scores) new_population.append(population[best_idx]) # ルーレット選択と交叉 total_fit = sum(fitness_scores) probs = [f / total_fit for f in fitness_scores] while len(new_population) < population_size: parents = np.random.choice(len(population), size=2, p=probs, replace=False) p1, p2 = population[parents[0]], population[parents[1]] child = ordered_crossover(p1, p2) child = mutate(child, mutation_rate=0.02) new_population.append(child) population = new_population best_route = population[np.argmax([calculate_fitness(ind) for ind in population])] print(f"探索完了!最短距離: {calculate_distance(best_route):.2f}") この実装で重要なのは、TSP特有の制約(同じ都市を二度通ってはならない)を満たすために順序交叉(Ordered Crossover: OX)を採用している点です。単純な一点交叉を行うと同一都市の重複が発生してしまいます。解くべき問題の物理的制約に合わせて遺伝子表現と交叉ロジックを設計することこそが、現場開発における最重要ステップです。

【実態検証】産業界での遺伝的アルゴリズム応用事例と遺伝的プログラミングの進化
遺伝的アルゴリズムは、単なるアカデミックな理論にとどまらず、産業界の極めてシビアな設計現場で長年にわたり決定的な成果を出し続けています。
JR新幹線先頭車両の空力形状設計
日本の新幹線(500系や700系、E5系など)の先頭ノーズ形状開発において、GAと流体力学シミュレーション(CFD)を融合させた多目的最適化が導入された事例は世界的に有名です。トンネル突入時の微気圧波(騒音)低減と空気抵抗の最小化、さらには客室容積の確保という、互いに相反するトレードオフの関係にある複数条件からパレート最適解を導き出しました。
NASAの宇宙探査用展開アンテナ
NASAエイムズ研究センターが2006年の「宇宙技術5号(ST5)」衛星に搭載したアンテナは、GAの進化プロセスによって完全自動設計されました。人間が直感では到底思いつかないような複雑に曲がりくねった有機的なワイヤー形状をしており、要求された電磁波放射パターンを従来の人間設計アンテナを凌駕する効率で満たした実例です。
遺伝的プログラミング(GP)への飛躍
GAを発展させ、1990年にジョン・コザ(John Koza)氏が提唱した遺伝的プログラミング(Genetic Programming: GP)では、遺伝子の表現に「構文木(Tree構造)」を採用しています。これにより、パラメータの数値だけでなく、プログラムのアルゴリズムや数式そのものを自己進化させることが可能になりました。金融市場における高頻度取引(HFT)のシグナル抽出ルールや、未知の物理現象の支配方程式をデータから自動発見する記号回帰(Symbolic Regression)に応用されています。
一般に知られていない盲点とネットの誤解
Web上の一部コミュニティでは、「ディープラーニングが普及した現代において、遺伝的アルゴリズムは過去の技術である」といった論調が見受けられますが、これは完全な誤解です。
深層学習は強力ですが、それはあくまで大量のラベル付きデータや適切な損失関数が定義できる場合に限られます。「どのニューラルネットワーク構造が最も軽量で高精度か」というメタ構造の決定(Neural Architecture Search: NAS)や、「工場のシフト計画」「配送ルートの混雑回避」といった離散的・非線形な制約条件の解決において、バックプロパゲーションは無力です。
また、現場のエンジニアが陥りがちな最大の盲点は「早期収束(Premature Convergence)」です。適応度の計算があまりに偏った淘汰圧を生み出すと、探索開始直後に特定の平凡な個体のコピーで集団が埋め尽くされ、進化がストップしてしまいます。現場のプロは、集団を小グループに分割して並行進化させ、時折個体を移住させる「島モデル(Island Model)」や、遺伝的多様性を適応度とは別に評価する「シェアリング法」を組み合わせてこの罠を打破しています。
【2026年最新動向】LLMプロンプト自動最適化とニューロエボリューションの衝撃
2026年現在、遺伝的アルゴリズムは先端AI研究の最前線で爆発的な再評価を受けています。その代表格がLLM(大規模言語モデル)のプロンプト自己進化とニューロエボリューション(Neuroevolution)です。
最新の研究(EvoPrompt等)では、プロンプトのテキスト自体を遺伝子とみなし、LLMに交叉や突然変異(表現の言い換えや論理ステップの挿入)を行わせ、タスク精度を適応度として世代交代させる手法が実用化されています。人間のプロンプトエンジニアが何日もかけて試行錯誤するよりも、短時間で圧倒的に精度の高いプロンプトが自動生成される環境が整っています。
【プロの結論】おすすめできる開発・慎重になるべき開発の判断基準
システム開発や研究において、遺伝的アルゴリズムを採用すべきかどうかの客観的な選定基準は以下の通りです。
- GAの採用を強く推奨するケース:
- 問題の評価関数が不連続、あるいはルールベースのシミュレータ出力である場合
- 巡回セールスマン問題やナプサック問題のように、順序や離散値の組み合わせ数が爆発している場合
- 初期の探索範囲が広大で、どこに最適解が存在するか見当もつかないブラックボックス最適化
- 他の手法を優先・併用すべきケース:
- 目的関数が明確に数式化され、数学的に滑らかで微分可能な場合(勾配降下法やニュートン法の方が圧倒的に高速)
- 1回の適応度評価に数分以上かかり、並列計算環境も用意できない場合(ベイズ最適化等のサロゲートモデル利用を推奨)
- 100%の理論的厳密解(数学的最適性証明)が絶対に要求されるミッションクリティカルな制約問題(整数計画法ソルバーなどを推奨)
【遺伝的アルゴリズム】に関するよくある質問(FAQ)
Q1:遺伝的アルゴリズムをPythonで開発する際、ライブラリは何を使うべきですか?
A1:本格的な開発では、世界標準の進化計算フレームワークであるDEAP(Distributed Evolutionary Algorithms in Python)が最も推奨されます。遺伝子構造(リスト、ツリー、辞書型など)を柔軟に定義でき、並列化も容易です。軽量な最適化であればscipy.optimize.differential_evolution(差分進化)も即座に利用可能です。
Q2:適応度関数(Fitness Function)を設計する際の最大の注意点は何ですか?
A2:適応度に「微小な差」が反映されるように設計することです。全滅に近い不正解に対して一律でスコア0を返してしまうと、個体間の優劣がつかず選択がランダムウォークになってしまいます。制約違反の度合いに応じた「ペナルティ関数」を滑らかに付与し、少しでも良い方向に進んだ個体が生き残りやすくする設計が不可欠です。
Q3:突然変異率や個体数はどのくらいに設定するのが標準的ですか?
A3:問題の複雑さに依存しますが、一般的な初期パラメータとしては個体数50〜200、交叉率0.7〜0.9(70〜90%)、突然変異率0.01〜0.05(1〜5%)が目安とされます。突然変異率が高すぎると単なるランダム探索になり、低すぎると早期収束を起こします。
まとめ:進化の原理が拓く未来とエンジニアが押さえるべき本質
遺伝的アルゴリズムは、自然界が何十億年もかけて実証してきた「試行錯誤と淘汰」という生命の知恵をコードに落とし込んだ、極めて堅牢で美しいメタヒューリスティクス手法です。
ディープラーニングや生成AIが全盛を迎えた現代においても、ブラックボックス最適化や自律型エージェントの創発的進化、さらには量子アニーリングとのハイブリッド探索において、その存在感は揺らぐどころか増しています。微分に頼らない柔軟な問題解決アプローチを自身の武器として持っておくことは、これからのAI・システム工学に携わる全てのエンジニアにとって、代えがたい強みとなるはずです。 (出典: 遺伝 的 アルゴリズム(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
