Scikit-learnを用いた計算例
ビジネスの意思決定や機械学習モデルの構築において、予測の精度やモデルの妥当性を測る最重要指標の一つが「決定係数(R2)」です。データ分析の現場では日常的に使われる指標ですが、実務の現場では「どの程度の数値を目標にすべきか」「相関係数と何が違うのか」「なぜ計算結果がマイナスになるのか」といった疑問や解釈の混乱が頻繁に見られます。
本記事では、統計学や回帰分析の初学者から実務でデータを取り扱うビジネスパーソンまでを対象に、決定係数の本質的な意味から計算式、実務上の目安、そして現場で直面しがちな落とし穴までを分かりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:決定係数(\(R^2\))は「目的変数のばらつきをモデルがどれだけ説明できているか」を示す指標であり、一般に0から1の範囲でモデルの当てはまりの良さを表す。
- 要点2:単回帰分析では相関係数の2乗と一致するが、重回帰分析では変数の増加で見かけ上の数値が上昇するため「自由度調整済み決定係数」の確認が必須となる。
- 要点3:切片のないモデルや未知のテストデータに対する予測では数値がマイナスになる場合があり、数値の高さだけでなく仮説検定や残差プロットを併用した総合判断が不可欠である。
【基礎知識】決定係数(R2)の意味と回帰分析における役割をわかりやすく解説
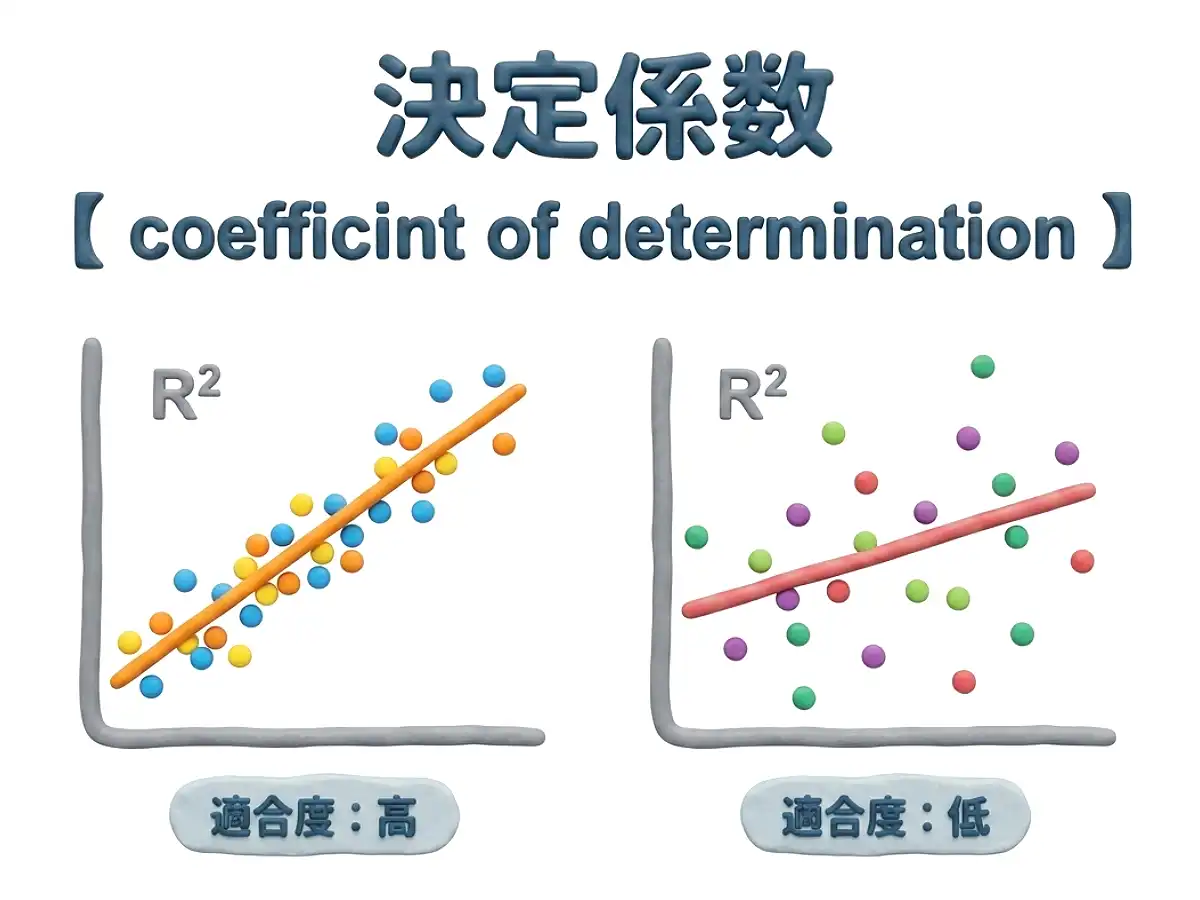
統計学や回帰分析において頻出する決定係数は、英語の「Coefficient of Determination」の訳であり、一般に「\(R^2\)(アールスクエア/アールじじょう)」と表記されます。この指標の役割を端的に言えば、「手元にあるデータ全体のばらつきのうち、作成した予測モデルによって説明できている割合」を数値化したものです。
例えば、売上高を予測するために広告費を用いた回帰モデルを作成し、決定係数が「0.80」と算出されたとします。これは「売上高のばらつき(変動)の80%は広告費の多寡によって説明できる」ことを意味し、残りの20%は競合の動向や天候、季節要因などモデルに含まれていない他の要因によるばらつきであると解釈します。
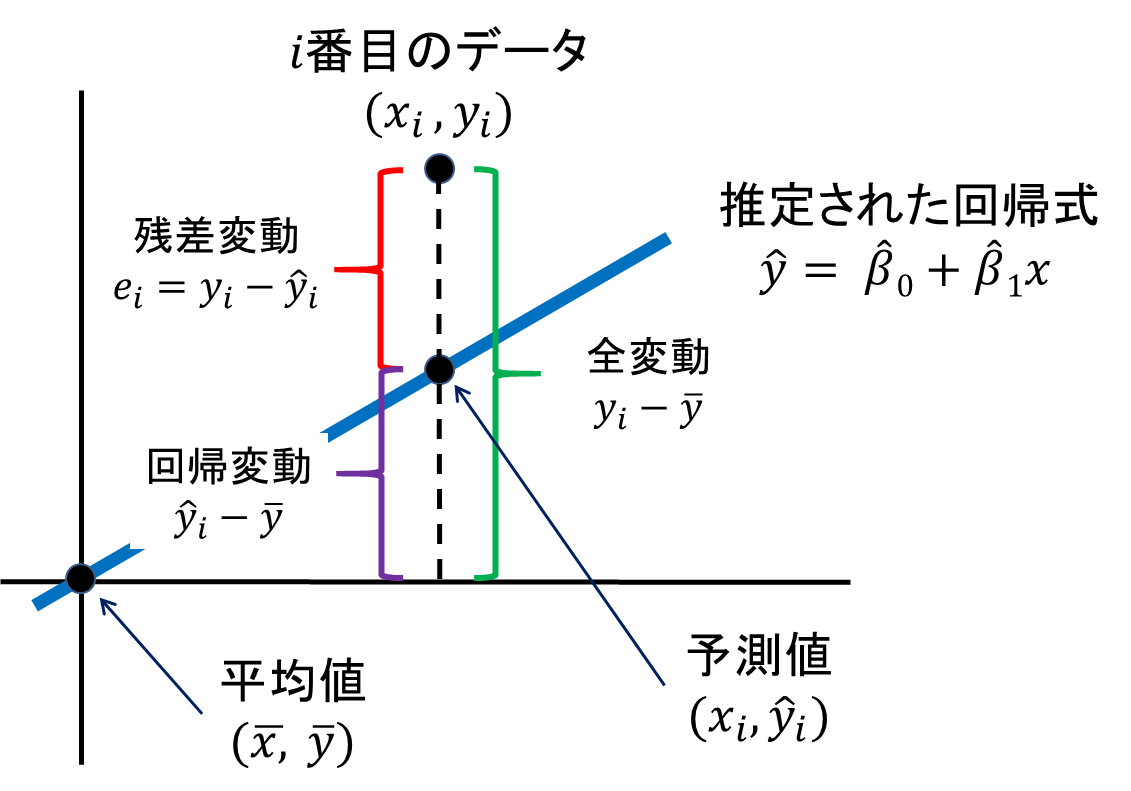
数学的な構造としては、データ全体のばらつきである「全変動(全平方和)」を、モデルが説明できた「回帰変動(回帰平方和)」と説明できなかった「残差変動(残差平方和)」に分解し、全体に対する回帰変動の比率として定義されます。直感的に理解するならば、「予測の当てはまり度合いをパーセンテージで表したスコア」と捉えると実務上の把握がスムーズです。
決定係数と相関係数の決定的な違い|なぜ単なる二乗では済まないのか?
初学者が最も混同しやすいのが「相関係数(ピアソンの積率相関係数、記号:\(r\))」との関係性です。両者は密接に関連していますが、分析の目的と数学的な性質において明確な違いが存在します。
単一の説明変数から目的変数を予測する「単回帰分析」においては、決定係数は相関係数の2乗(\(R^2 = r^2\))と完全に一致します。例えば相関係数が0.7であれば、決定係数は \(0.7^2 = 0.49\)(約49%)となります。しかし、複数の要因を同時に考慮する「重回帰分析」や非線形モデルにおいては、単純な2乗関係は成り立ちません。
両者の本質的な相違点は、相関係数が「2つの変数間における直線的な関連の強さと向き(正・負)」を示す対称な指標であるのに対し、決定係数は「原因(説明変数)が結果(目的変数)をどれだけ説明・予測できるか」という因果モデルの予測力を評価する非対称な指標である点にあります。単に相関が高いことと、実務に耐えうる予測モデルが組めていることは同義ではないため、分析設計に応じた使い分けが求められます。
【一覧表で比較】決定係数の目安と評価基準|業界・用途ごとの実践的ボーダーライン
「決定係数はいくつ以上あれば良いのか」という疑問に対し、統計学的な絶対基準は存在しません。許容される水準は、扱うデータの性質(物理データか人間行動データか)やビジネスの目的によって大きく異なります。
| 分野・対象データ | 一般的な決定係数の目安 | 数値の評価基準 | 実務における注意点 |
|---|---|---|---|
| 自然科学・物理実験・品質管理 | 0.90以上(90%以上) | 高精度で再現性が極めて高い | ノイズが少ない環境のため、0.90未満は測定誤差やモデル不備を疑う |
| 経済予測・財務モデリング | 0.50〜0.70程度 | 実務的な傾向把握に十分耐えうる | マクロ環境要因が複雑に絡むため、0.80超は過学習(オーバーフィッティング)を警戒 |
| マーケティング・消費者行動分析 | 0.30〜0.50程度 | 施策立案の示唆として有用 | 人間の心理や購買行動は個別ノイズが大きく、低めの数値でも統計的有意なら価値がある |
| 医療・社会学・アンケート調査 | 0.20〜0.40程度 | 特定の要因の寄与が確認できる水準 | 決定係数そのものより、説明変数のp値(有意確率)が重視される傾向が強い |
実務においては、「0.7を超えていないから役に立たないモデル」と短絡的に切り捨てるのは危険です。ノイズの多い行動ログ分析などでは、決定係数が0.3であっても施策改善の確固たるエビデンスとして機能することが多々あります。

決定係数の計算方法と「自由度調整済み決定係数」の重要性|重回帰分析での解釈
決定係数の計算式は、前述の平方和を用いて以下のように表されます。
\(R^2 = 1 - \frac{\sum (y_i - \hat{y}_i)^2}{\sum (y_i - \bar{y})^2} = 1 - \frac{\text{残差平方和 (SSE)}}{\text{全平方和 (SST)}}\)
ここで \(y_i\) は実測値、\(\hat{y}_i\) はモデルによる予測値、\(\bar{y}\) は実測値の平均値を表します。すべての予測が実測値と完全一致すれば残差平方和が0となり、\(R^2 = 1\) となります。
しかし、複数の説明変数を用いる重回帰分析においては、重大な数学的欠陥が生じます。それは「目的変数と無関係なゴミデータを説明変数として追加しても、数学の構造上、決定係数は決して下落せず上昇し続ける」という性質です。
この見せかけの上昇を防ぐために導入されるのが「自由度調整済み決定係数(修正済み決定係数、記号:\(\bar{R}^2\))」です。自由度調整済み決定係数は、サンプルサイズ(\(n\))と説明変数の数(\(k\))を考慮し、無駄な変数を追加した際にペナルティを課す計算式になっています。
\(\bar{R}^2 = 1 - \frac{\text{SSE} / (n - k - 1)}{\text{SST} / (n - 1)}\)
重回帰分析の実務においては、通常の決定係数ではなく、必ずこの自由度調整済み決定係数を確認し、変数の追加によってモデルの真の汎化性能が向上しているかを吟味しなければなりません。
数値がマイナスになる驚きの理由とは?実務で陥る解釈の落とし穴と仮説検定
「決定係数は0から1の間の値をとる」と教わった多くの分析者が直面するのが、「計算結果がマイナス(負の値)になった」という事態です。これには明確な統計的理由が存在します。
決定係数がマイナスになる主な要因は以下の2点です。
- 1. 回帰直線の切片を意図的に「0」に固定した場合:
原点を通る回帰モデルを強制すると、平均値を用いて予測するよりも残差が大きくなり、残差平方和が全平方和を上回る(\(\text{SSE} > \text{SST}\))現象が起き、\(1 - (\text{1以上の数値}) = \text{マイナス}\) となります。 - 2. 機械学習などで「訓練データで学習したモデル」を「未知のテストデータ」に適用した場合:
過学習を起こしたモデルを新規データに当てはめた結果、「単に実測値の平均値を予測値として出力し続けた場合」よりも予測誤差が大幅に悪化すると、決定係数の評価値は容易にマイナスへ転落します。
決定係数がマイナスを示した場合は、「このモデルは単純な平均値予測よりも精度が劣る、極めて不適切なモデルである」というシステムからの警告サインです。
さらに、決定係数を評価する際はモデル全体の仮説検定(F検定)を同時に確認する必要があります。決定係数が0.6と一見高く見えても、サンプル数が極端に少ない場合は統計的有意水準(\(p < 0.05\))を満たさず、単なる偶然の産物であるリスクがあるためです。
【実践手順】Excel(エクセル)とPythonで決定係数を求める具体的な方法
実務で決定係数を算出するための具体的な実装手順を解説します。
1. Excel(エクセル)での求め方
Excelでは複数のアプローチで瞬時に決定係数を取得できます。
- 散布図グラフから表示:データを選択して散布図を作成し、「近似曲線の追加」から「グラフに\(R-2\)乗値を表示する」にチェックを入れる。
- 関数を使用:単回帰であれば
=RSQ(既知のy, 既知のx)を使用。 - 分析ツール:「データ」タブの「データ分析」から「回帰分析」を実行すると、通常の決定係数と自由度調整済み決定係数、分散分析表(F値・p値)が一括出力されます。
2. Python(scikit-learn / statsmodels)での求め方
Pythonのデータサイエンス環境では、scikit-learn や statsmodels を用いるのが標準的です。
from sklearn.metrics import r2_score # y_true: 実測値, y_pred: モデルの予測値 r2 = r2_score(y_true, y_pred) print(f"決定係数 (R2): {r2:.4f}") # statsmodelsを用いた重回帰分析の詳細サマリー出力 import statsmodels.api as sm X = sm.add_constant(X_data) # 切片を追加 model = sm.OLS(y_data, X).fit() # サマリー内にR-squaredおよびAdj. R-squaredが出力される print(model.summary())
【実態検証】現場のアナリストが直面するリアルな課題とプロの結論
データ分析の現場やSNS上のコミュニティでは、「決定係数至上主義」に対する警鐘が度々鳴らされています。現場のアナリストやデータサイエンティストが直面する典型的なトラブル事例として、以下のような声が挙げられます。
「クライアント向け報告書で決定係数0.85のモデルを提出したところ、新規データ投入時に予測が大きく外れクレームになった。原因を精査すると、多重共線性(マルチコ)と過学習を見落としていた」「決定係数を上げようと説明変数を手当たり次第に放り込んだ結果、現場で運用不可能な複雑怪奇なモデルが出来上がってしまった」
こうした現場の失敗から導き出される専門的な判断基準は明確です。
【プロの結論】モデル採択において向いているケース・慎重になるべきケース
- 決定係数のみを信頼して良いケース:
データ数が十分に確保されており(最低でも数十〜数百サンプル以上)、説明変数同士に強い相関がなく、残差プロットに明らかな偏り(不均一分散や非線形傾向)が確認されない標準的な線形回帰。 - 決定係数以外の指標を優先すべきケース:
時系列データ予測(自己相関が存在するため見せかけの回帰が起きやすい)、変数が極めて多い機械学習モデル(RMSEやMAE、テストデータでの交差検証スコアを優先すべき)、および異常値の影響を強く受けているデータセット。
【決定係数とは】に関するよくある質問(FAQ)
Q1:決定係数が0.9以上なら、無条件で優れた予測モデルと言えますか?
A1:必ずしもそうとは言えません。サンプルサイズが小さすぎる場合や、目的変数とほぼ同義の変数が混入している「データリーク(情報漏洩)」、過学習が発生している可能性があります。必ず残差の正規性や未知データでのテストスコアを確認してください。
Q2:決定係数が低くても(例:0.2〜0.3)、ビジネスで活用できる場合はありますか?
A2:大いに活用できます。マーケティングや人事データなどノイズが多い領域では、決定係数は低く出やすい傾向があります。全体の予測精度は粗くても、特定の変数の係数が統計的に有意(p値が十分に小さい)であれば、「施策を打つべき方向性の根拠」として極めて有益です。
Q3:Excelで回帰分析をした際、「重決定 R」と「補正 R2」のどちらを見るべきですか?
A3:重回帰分析を行っている場合は、必ず「補正 R2(自由度調整済み決定係数)」を確認してください。「重決定 R」は相関係数(複数変数の場合は重相関係数)を示し、「R2」は通常の決定係数を示しています。
まとめ:数値の高さに惑わされずモデルの本質を見極める
決定係数(\(R^2\))は、回帰分析の適合度を直感的に把握できる非常に優れた指標です。しかし、その手軽さゆえに「数値が高ければすべて良し」という誤った解釈に陥りやすい側面を持っています。
単回帰と重回帰での解釈の違い、自由度調整の必要性、そしてマイナス値が示す警告の意味を正しく理解し、F検定や残差プロット、RMSEなどの他指標と組み合わせて評価することこそが、信頼性の高いデータ分析と意思決定を実現するための鍵となります。 (出典: 決定 係数 と は(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
