帰無仮説と対立仮説の違いとは?棄却の理由や覚え方をプロが徹底解説
データ分析やビジネスの意思決定、あるいは資格試験対策において、多くの学習者が最初に高い壁として感じるのが統計的仮説検定のロジックです。「なぜ証明したい主張を直接証明せず、わざわざ否定したい仮説を立てるのか」「どちらを棄却すればよいのか」という疑問は、統計学を学ぶ誰もが一度は抱く自然な違和感といえます。
仮説検定は、感覚や勘に頼らず「得られたデータに意味のある差があるか」を客観的に判断するための強力なフレームワークです。本稿では、直感的なメタファーを用いた覚え方から、判定ルールの根幹である有意水準とp値の関係、実務で頻出する過誤のリスクまで、現場目線で分かりやすく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:帰無仮説は「差や効果がない」とする出発点の仮説であり、対立仮説は本当に証明したい「差や効果がある」という仮説である。
- 要点2:直接証明が難しい「差がある」状態を、背理法に似たロジックで「偶然とは考えにくい」と示すことで帰無仮説を棄却し、対立仮説を採択する。
- 要点3:p値が有意水準(一般に5%)を下回ることで有意差を判定するが、第一種・第二種の過誤やサンプルサイズによる歪みを正しく理解して運用する必要がある。
【疑問を即解決】帰無仮説と対立仮説の違いとなぜ「無に帰す」のか
統計学を学び始めた人が真っ先に混乱するのが、帰無仮説と対立仮説の違いです。日常の議論では「自分が主張したいこと」をストレートに提示しますが、統計的仮説検定ではあえて逆の立て方をします。
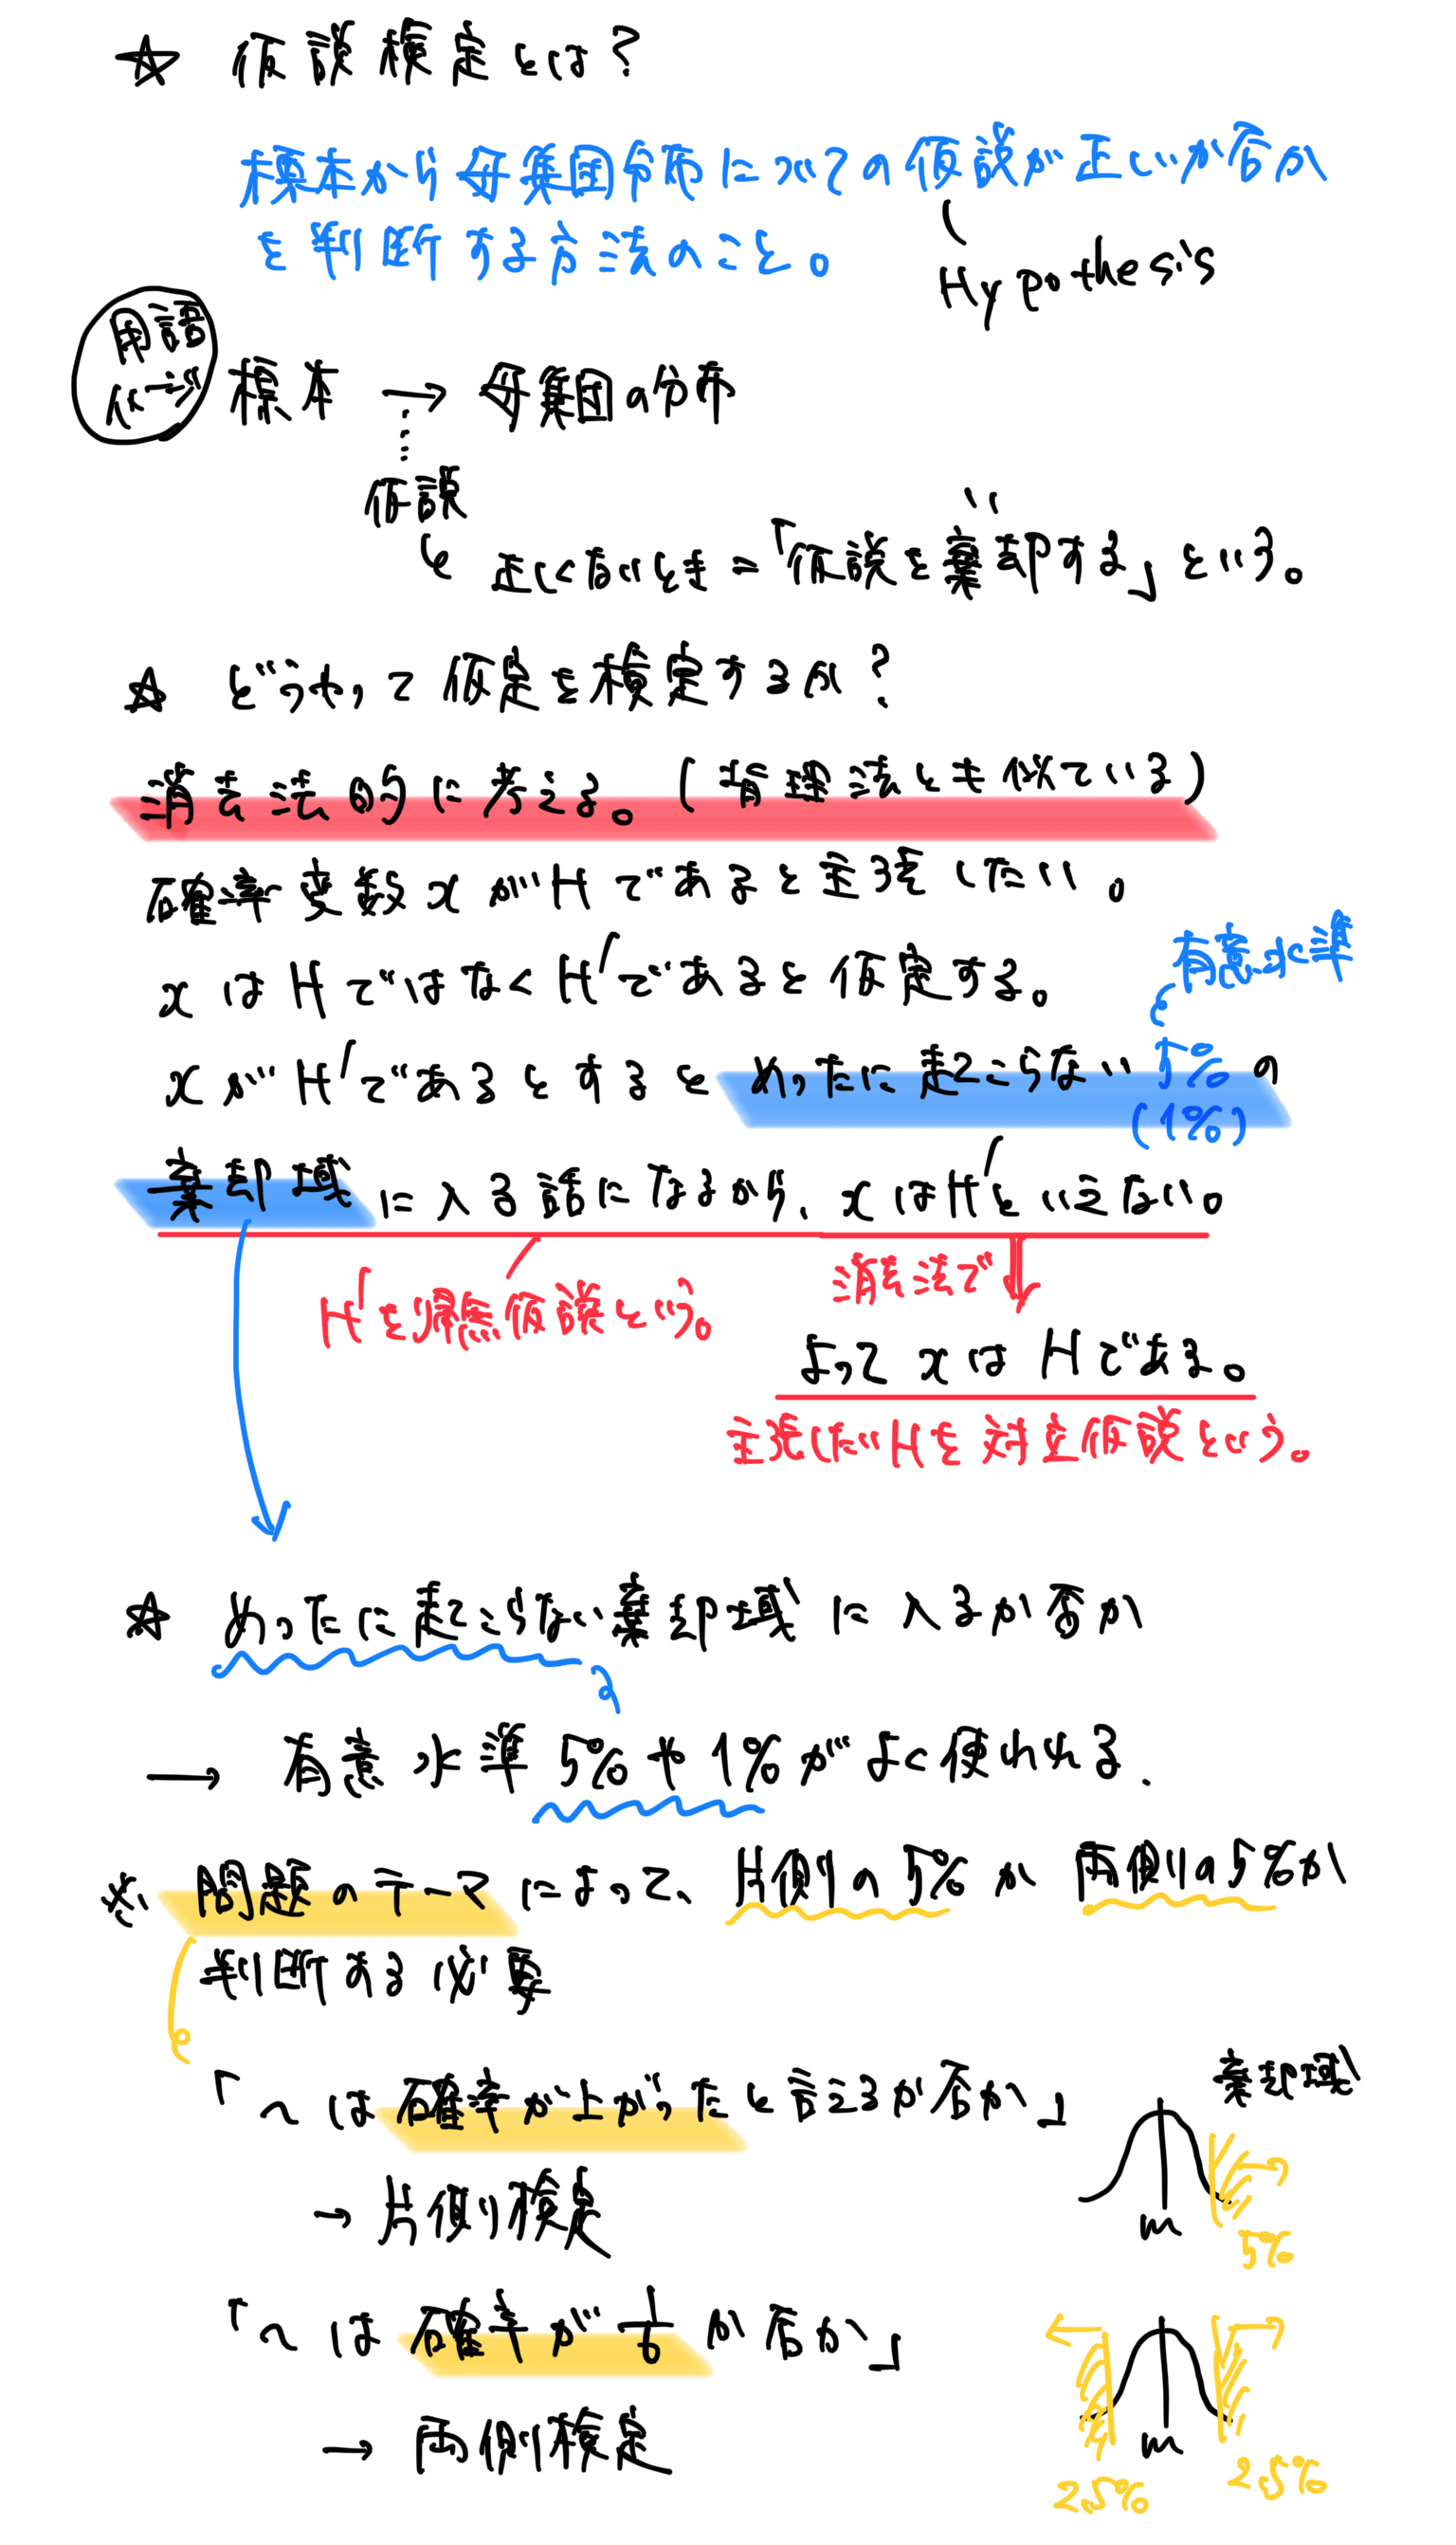
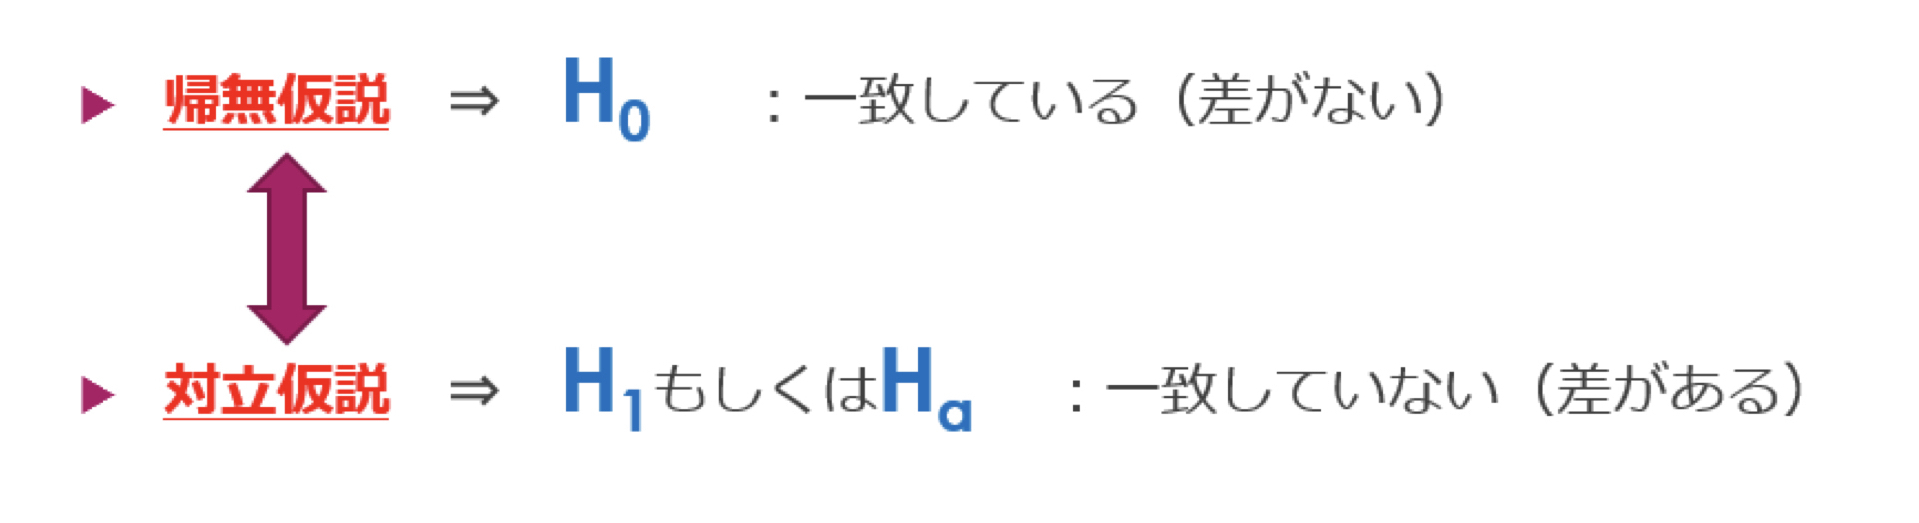
まず定義を整理すると、2つの仮説は明確に対立する関係にあります。
- 帰無仮説($H_0$):「新薬に効果はない」「2つの施策に差はない」といった、差や関連性を否定するベースラインの仮説
- 対立仮説($H_1$):「新薬に効果がある」「施策Aのほうが優れている」といった、研究者や分析者が実証したい本来の主張
なぜわざわざ「無に帰す仮説」と書くのかといえば、その名の通り「最終的に証拠を突きつけて打ち破り、無に帰せしめる(捨て去る)ための仮説」だからです。統計学では、何もない状態(差がゼロ、効果がゼロ)を基準として確率計算を行うため、数学的に確率分布を固定できる「差がない」状態を仮説として設定します。
帰無仮説の簡単な覚え方としては、裁判の「推定無罪の原則」を思い浮かべるのが最も直感的です。
- 裁判の前提:「被告人は無罪である」(帰無仮説:何事もない)
- 検察側の主張:「被告人は有罪である」(対立仮説:事件を起こした)
- 判断のプロセス:動かぬ証拠が揃わない限り無罪のまま。しかし「偶然ではあり得ない決定的な証拠」が提示されたときのみ、無罪の前提を捨てて有罪(対立仮説)を言い渡す。
このように「疑わしきは罰せず(差がない状態を基本とする)」というスタンスをとることで、誤った判断を下すリスクをコントロールしているわけです。
なぜ直接証明しない?帰無仮説を棄却する理由と背理法のロジック
「新薬に効果があるなら、最初から『効果がある』と証明すればいいのでは?」という疑問はごく自然なものです。しかし、ここには科学的な推論の根本的な限界が関わっています。
数学の「背理法」を思い出してください。「命題が成り立たないと仮定し、そこから矛盾を導くことで、元の命題が正しいことを証明する」手法です。統計学における帰無仮説を棄却する理由も、まさにこの背理法の思想に基づいています。
例えば、「このコインは表が出やすい不正なコインだ(対立仮説)」と直接証明しようとしても、「表が出る確率が60%なのか70%なのか、あるいは51%なのか」は無限にパターンがあり、基準となる確率モデルを1つに決められません。一方で「このコインは歪みのない普通のコインだ(確率50%:帰無仮説)」と仮定すれば、厳密な二項分布から「10回連続で表が出る確率(約0.1%)」を正確に計算できます。
この「計算可能な基準」から極めて起こりそうにない珍しいデータが得られたとき、「差がないという前提そのものが間違っていた」と判断し、対立仮説の採択ルールに従って対立仮説を採用します。これが有意差の判定理由における統計的アプローチの核心です。
【比較データ表】仮説検定の重要パラメータと判定基準一覧
仮説検定を正しく運用・解釈するためには、関係する概念や数値の役割を整理しておくことが欠かせません。実務や試験で頻出する要素を体系的にまとめました。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 帰無仮説($H_0$) | 「差がない・効果がない」とする仮説 | 検証の初期前提 | 棄却することを狙って設定する基準点 |
| 対立仮説($H_1$) | 「差がある・効果がある」とする仮説 | 本来証明したい主張 | 帰無仮説が棄却された際に採択される |
| 有意水準($\alpha$) | 稀であるとみなす確率の境界値 | 5%(0.05)または1%(0.01) | データを見る前に事前に設定するのが鉄則 |
| p値(Probability value) | 帰無仮説のもとでそのデータが得られる確率 | $p < \alpha$ で有意差あり | 小さいほど「偶然とは考えにくい」を示す |
| 第一種の過誤($\alpha$エラー) | 「本当は差がないのに誤って棄却する」ミス | 発生確率の上限は有意水準(5%など) | 偽陽性。無駄な投資や誤った承認につながる |
| 第二種の過誤($\beta$エラー) | 「本当は差があるのに見逃す」ミス | 一般に10〜20%以下(検出力80%以上) | 偽陰性。有望な施策や新薬の発見を逃す |

日常とビジネスで見る仮説検定のわかりやすい具体例
抽象的な数式だけでは理解しにくいため、実際のビジネスや研究現場を想定した仮説検定のわかりやすい具体例を見てみましょう。
例えば、ECサイトのデザイン改修におけるABテストを考えます。従来の購入ボタン(A案)と、新デザインの購入ボタン(B案)でコンバージョン率を比較する場合です。
- 帰無仮説($H_0$):A案とB案の購入率に差はない(デザイン変更に効果はない)
- 対立仮説($H_1$):A案とB案の購入率には差がある(デザイン変更に効果がある)
各案にユーザーを1,000人ずつ割り振ってテストした結果、購入率が「A案:3.0%」「B案:5.5%」となったとします。ここで統計ソフトウェアを用いて検定を行うと、$p = 0.004$(0.4%)という値が算出されました。
有意水準とp値の判定基準に照らし合わせると、事前に決めた有意水準5%(0.05)に対して $0.004 < 0.05$ となるため、「偶然この差が生じる確率はわずか0.4%しかない」と判定できます。結果として帰無仮説は棄却され、B案に効果があるという対立仮説が採択されます。
検定設計で知っておくべき「両側検定」と「片側検定」の違い
仮説を立てる際、両側検定と片側検定の違いを意識することが重要です。
「新デザインのほうが良いか悪いか分からないが差を見たい」場合は両側検定を用います。確率分布の両端(左右2.5%ずつ、計5%)に棄却域を設けます。
一方、「構造上、新デザインが悪化することはあり得ず、向上したかどうかのみを検証したい」と事前に明確な方向性がある場合は片側検定を用い、片側の裾野(5%)に棄却域を集中させます。片側検定のほうが有意差を検出しやすい反面、「実は新デザインのほうが悪かった」という逆方向の重要な変化を見落とす危険性があるため、実務では慎重な判断が求められます。
分析手法の選び方:t検定とカイ二乗検定
検定対象となるデータの性質によって、使用する統計手法も異なります。実務で最も多用されるのがt検定とカイ二乗検定です。
- t検定:「売上金額」や「滞在時間」など、連続する数値の平均値に差があるかを比較する際に利用(例:2つの店舗グループの平均売上比較)
- カイ二乗検定:「クリックした/しない」「合格/不合格」など、カテゴリーデータの割合や独立性を検証する際に利用(例:男女比による購買傾向の違い)
【実態検証】統計検定の出題傾向と初学者が陥る「二種類の誤り」の罠
一般社団法人日本統計学会が認定する「統計検定」の試験現場や、実務でのデータ分析において、最も頻繁に問われ、かつミスが多発するのが第一種の過誤と第二種の過誤の整理です。
統計検定の出題傾向を分析すると、単に公式を当てはめるだけでなく、「第一種の過誤を犯す確率が何に等しいか(=有意水準 $\alpha$)」「サンプルサイズを増やすと第二種の過誤 $\beta$ はどう変化するか(=減少する)」といった本質的な理解を問う問題が定番化しています。
知恵袋や学習コミュニティに寄せられる受講生の声を見ても、「$\alpha$ と $\beta$ のどっちがどっちだか本番で分からなくなる」という悲鳴が目立ちます。これをスッキリ整理する視点が「エラーがもたらす実害の比較」です。
- 第一種の過誤(あわてんぼうの誤り):効果がないのに「効果がある!」と判断してしまう(無駄な広告費を投じる、無効な薬を発売する)
- 第二種の過誤(ぼんやりものの誤り):本当は効果があるのに「効果がない」と見過ごしてしまう(有望な新薬の開発を中止する)
有意水準 $\alpha$ を厳しく(例えば5%から1%に)設定すると、第一種の過誤は防ぎやすくなりますが、その分警戒心が強まりすぎて第二種の過誤 $\beta$ が増えるというトレードオフの関係にあります。この両者のバランスを設計することこそが検定計画の要となります。
一般に知られていない盲点とネットの誤解|p値ハッキングと有意性の過信
インターネット上の解説や入門書の一部では、「$p < 0.05$ なら確実、大成功」という極端な記述が見受けられますが、これは現場で大きな判断ミスを引き起こす代表的な誤解です。
特に注意すべきなのが「サンプルサイズが極大化すると、微小な無意味な差でもp値が小さくなってしまう」という統計学の性質です。ビッグデータ分析などでサンプル数が数十万件に達すると、売上がわずか0.01%上がっただけの「ビジネス上意味のない差」であっても、$p < 0.001$ となり「統計的に有意」と判定されてしまいます。
また、有意な結果が出るまで分析軸を変えたりデータを追加したりする行為は「p-hacking(p値ハッキング)」と呼ばれ、科学的妥当性を著しく損なう行為として学術界・産業界で問題視されています。
【プロの結論】データドリブン時代に身につけるべき批判的思考力
統計的有意差(Statistical Significance)と、実務的な有意性(Practical Significance)はイコールではありません。データサイエンスの現場で求められるのは、「p値が0.05を下回ったから採用」と機械的に判断することではなく、「その差にどれだけの効果量(Effect Size)があり、費用対効果に見合うのか」を総合的に見極める批判的思考力です。
数値を単なる免罪符として使うのではなく、背後にある不確実性のリスクを正しく評価できる人材こそが、真のデータ活用を推進できます。
仮説検定の手順詳細まとめ|実務で迷わない5ステップ
実際に仮説検定を実施する際の標準的なワークフローを、仮説検定の手順詳細まとめとして整理しました。この流れを頭に入れておくことで、試験でも実務でも迷わず進行できます。
- ステップ1:仮説の設定
棄却したい「帰無仮説($H_0$)」と、証明したい「対立仮説($H_1$)」を明確に定義する。片側検定か両側検定かもここで決定する。 - ステップ2:有意水準($\alpha$)の決定
データを集める前に、稀であると判断する基準値(一般には5%または1%)を確定させる。 - ステップ3:検定統計量の算出
収集したデータから、標本平均や分散を用いて適切な検定統計量(t値やカイ二乗値など)を計算する。 - ステップ4:p値の算出と棄却域の確認
得られた検定統計量が発生する確率(p値)を求める。 - ステップ5:結論の導出
$p < \alpha$ であれば「帰無仮説を棄却し、対立仮説を採択(有意差あり)」。$p \ge \alpha$ であれば「帰無仮説を棄却できない(有意差があるとはいえない)」と結論づける。
【帰無仮説・対立仮説】に関するよくある質問(FAQ)
Q1:p値が0.05以上だった場合、帰無仮説は「正しい」と証明されたことになりますか?
A1:いいえ、「帰無仮説が正しい」と証明されたわけではありません。あくまで「手元のデータからは差があるとは言い切れない(証拠不十分)」という保留の状態を意味します。裁判で言えば「証拠不十分で無罪」になっただけであり、真実として潔白が証明されたのとは異なります。
Q2:どちらを帰無仮説にすべきか迷ったときの鉄則はありますか?
A2:「現状維持」「差がない」「変化がない」という状態を帰無仮説に設定するのが鉄則です。新技術や新施策など、「新しく主張したいポジティブな変化」は必ず対立仮説に置きます。
Q3:第一種の過誤と第二種の過誤は、どちらをより警戒すべきですか?
A3:用途によって異なります。創薬や安全性試験では「効果がない薬を誤認するリスク(第一種の過誤)」を厳しく制限します。一方で、病気のスクリーニング検査や重大なシステム障害の予兆検知では「見逃しのリスク(第二種の過誤)」を避けることが最優先されます。
まとめ:統計的仮説検定を武器にするための実践的視点
帰無仮説と対立仮説の構造は、一見すると回りくどい論理展開に思えますが、「確証バイアス」に囚われやすい人間が客観的な判断を下すために編み出された極めて堅牢な知恵です。
「否定したい前提(帰無仮説)」をあえて設定し、データが示す確率(p値)に基づいて厳格に採否を決める。この基本ルールをマスターすれば、統計検定の合格はもちろん、ビジネスにおける施策検証やAI・データ利活用の場面でも、根拠に基づいた的確な意思決定が可能になります。 (出典: 帰 無 仮説 対立 仮説(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
